
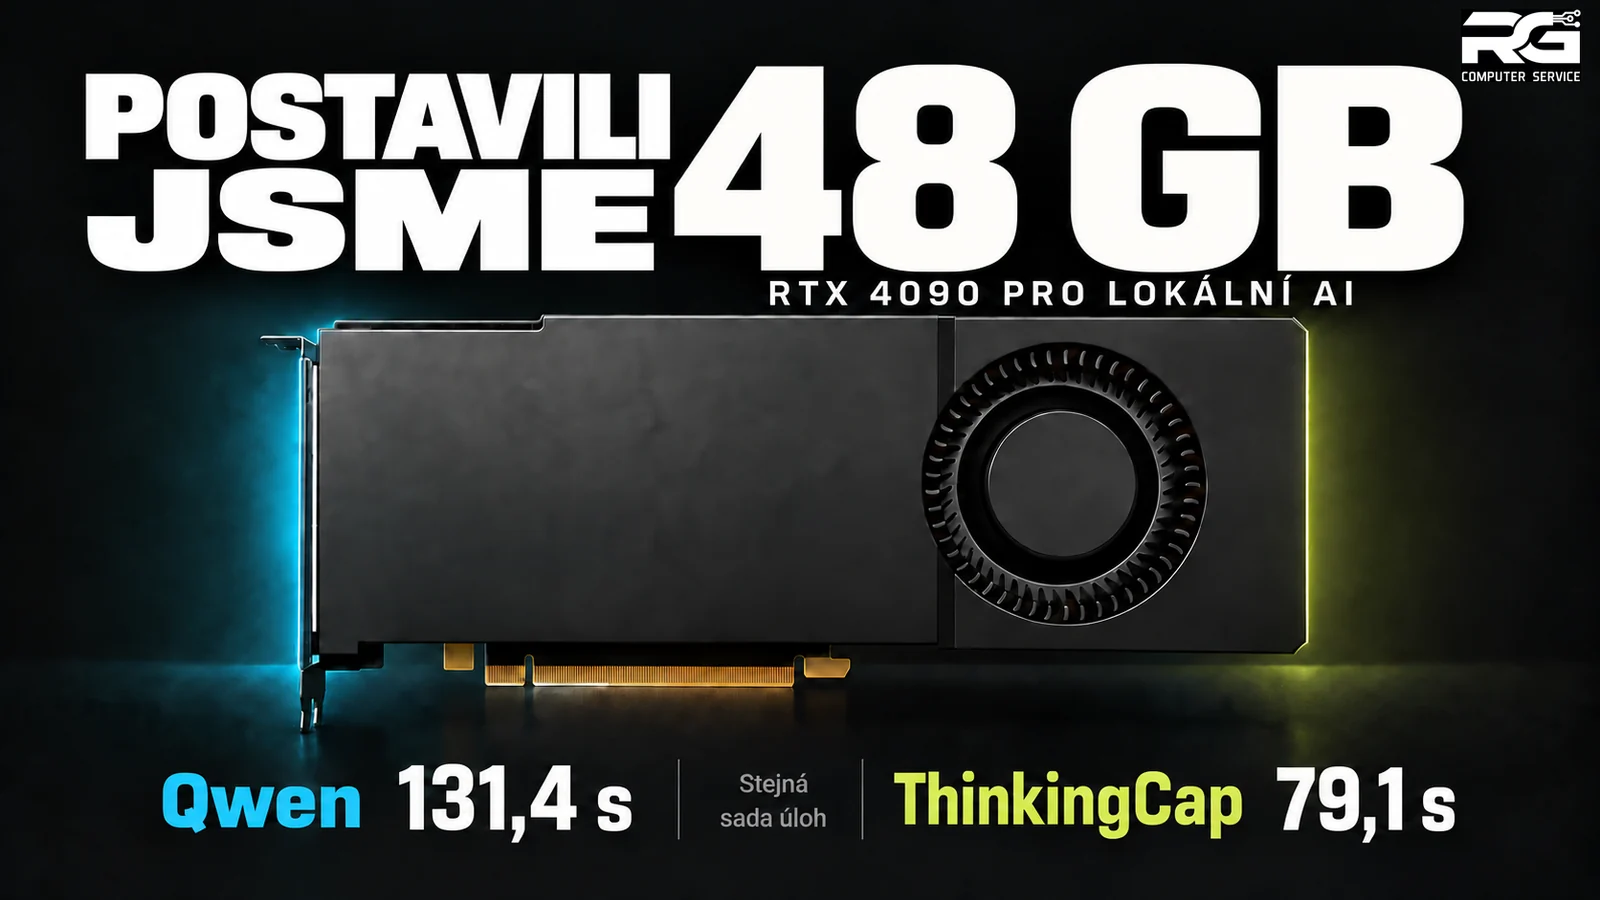
Záchrana hardwaru, 48 GB paměti a praktické srovnání s ThinkingCapem od BottleCap AI.
V servisu se nám sešly dvě RTX 4090 s prasklým PCB u PCI Express konektoru. První jsme přestavěli na 48GB kartu pro lokální AI — a ověřili, co na ní dokáže původní Qwen a ThinkingCap od BottleCap AI.
Prasklé PCB nemusí znamenat konec grafického čipu
Tady nešlo o poškrábaný kontakt nebo ulomený kousek plastu. Praskla samotná deska a přerušily se vodivé spoje. U PCIe konektoru vedou signály i napájecí propojení do dalších částí karty. Poškození proto může vyřadit celý jinak hodnotný hardware.
PCB je vícevrstvé: měděné cesty nejsou jen na povrchu, ale také uvnitř. Když prasklina protne tyto spoje, pouhé slepení desky elektrické propojení neobnoví. O rozsahu opravy rozhoduje poloha praskliny a to, které spoje přerušila.
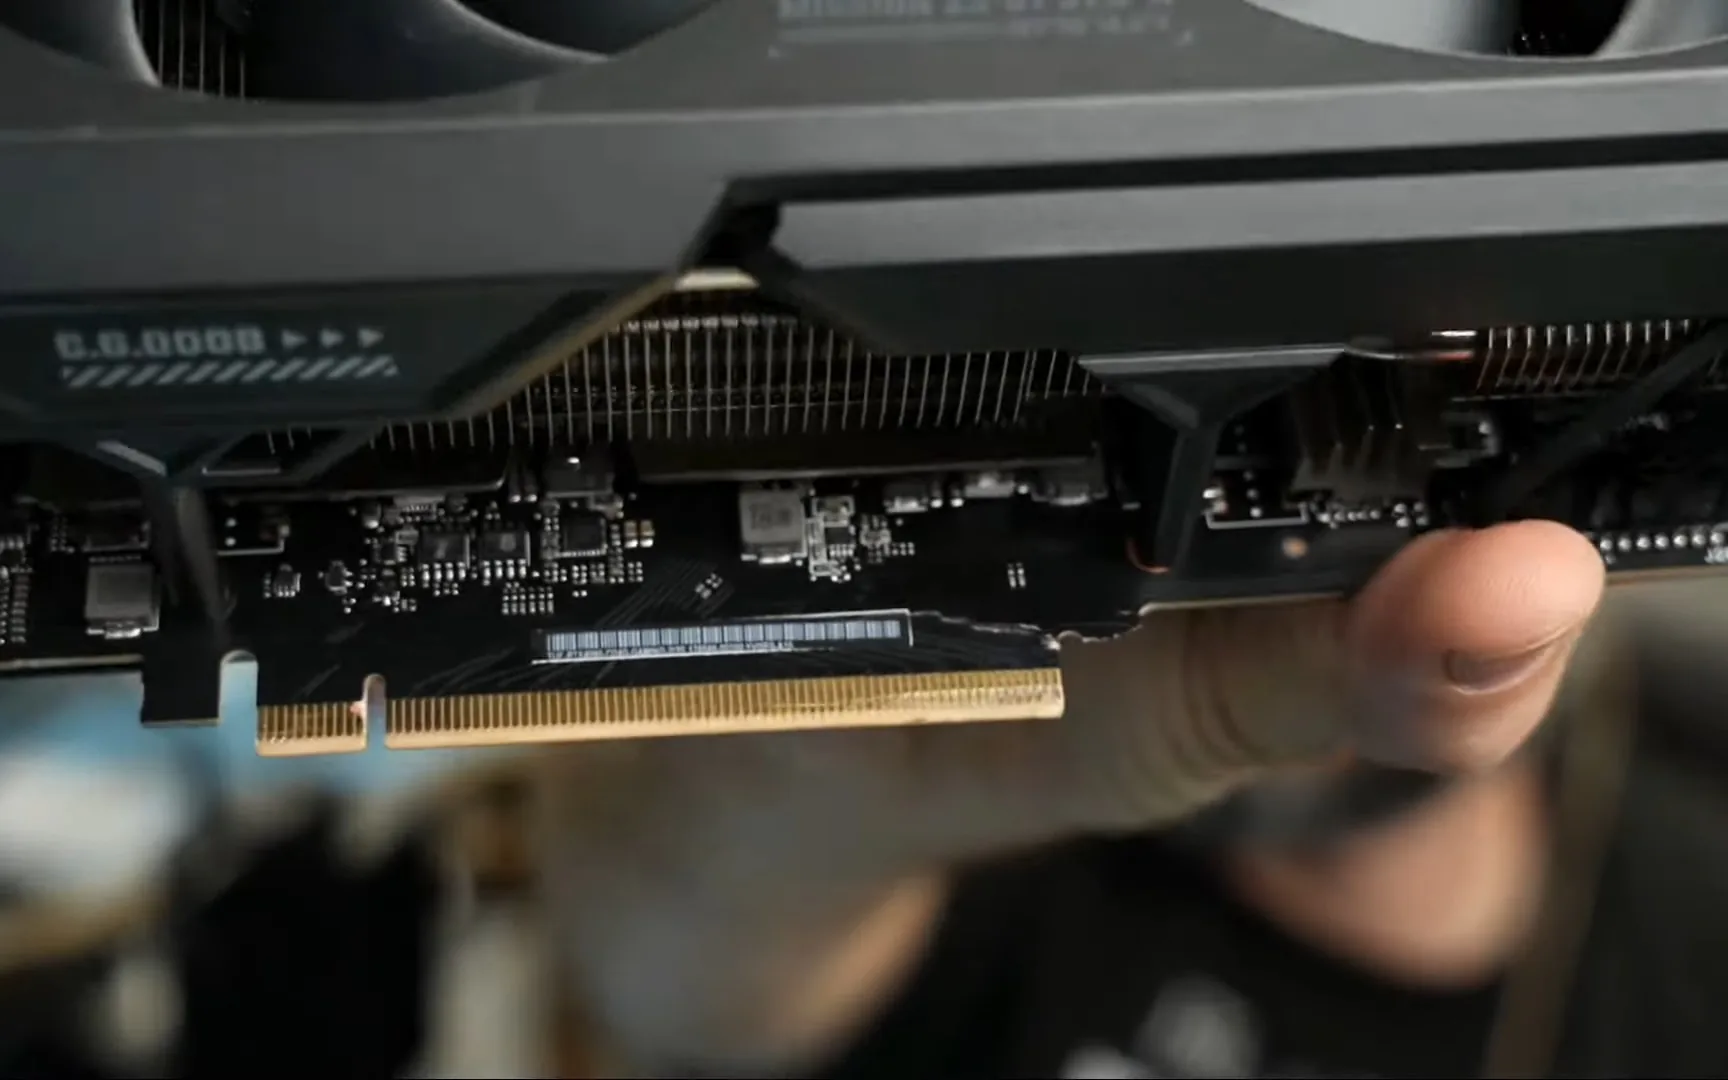
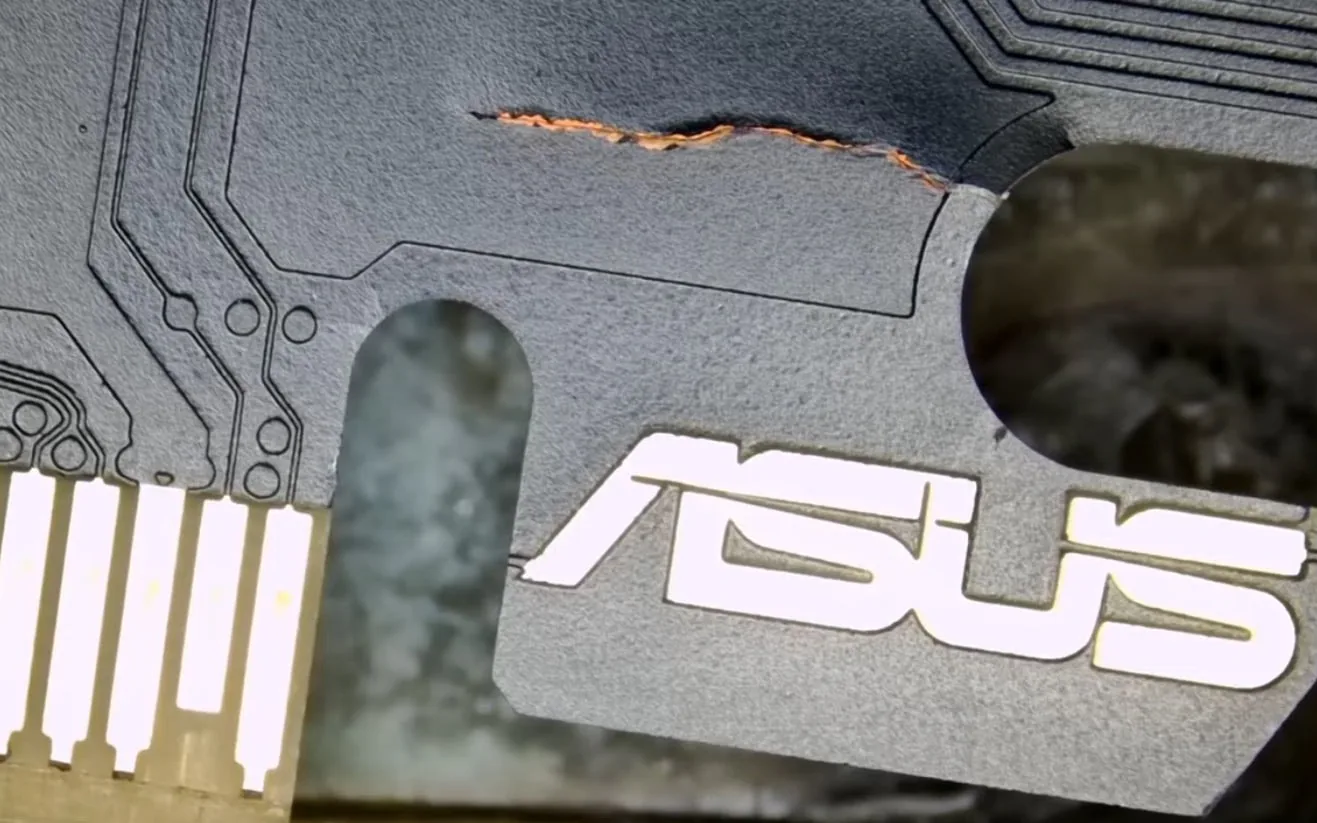
Dobrá zpráva je, že grafické jádro a paměťové čipy mohou takové mechanické poškození přežít bez závady. To otevírá cestu k opravě přenesením použitelných součástek na jinou desku. Právě v GPU zůstává velká část hodnoty karty.
U první karty jsme se rozhodli jít dál než k obnově původního stavu: zachovat použitelné jádro a získat větší paměť pro lokální AI.
AD102 a paměti: cesta k 48 GB
Základem zůstal NVIDIA AD102 z RTX 4090. Běžná RTX 4090 má 24 GB GDDR6X; GeForce RTX 5090 má 32 GB GDDR7. Našich 48 GB není tovární varianta RTX 4090, ale výsledek hardwarové přestavby.
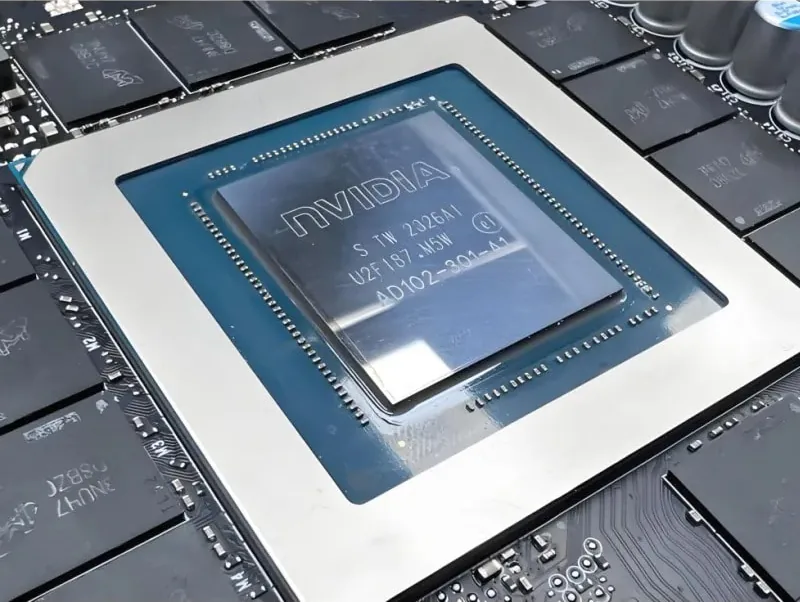
Standardní RTX 4090 má 12 paměťových čipů GDDR6X po 2 GB, umístěných na jedné straně PCB. Dohromady tedy 24 GB. Starší RTX 3090 používala 24 čipů po 1 GB: dvanáct vpředu a dvanáct vzadu, opět celkem 24 GB.
U 48GB přestavby se oboustranné uspořádání, známé jako clamshell, využije s dvojnásobnou kapacitou jednotlivých čipů: 12 × 2 GB vpředu + 12 × 2 GB vzadu = 48 GB VRAM. Přibývá tedy dvanáct dalších 2GB pamětí; pouhé přenesení původních dvanácti by kapacitu nezvýšilo.
Pro tyto přestavby lze pořídit nové náhradní PCB s již osazenými napájecími obvody a drobnými součástkami, ale bez GPU a VRAM. Nejde o holý laminát ani o běžnou desku, do které se čipy zasunou. Principem navazuje na oboustranné paměti RTX 3090, zapojení však musí být přizpůsobené jádru AD102 a 48GB konfiguraci. Samotná podobnost pouzder nestačí: správné musí být i propojení signálů a napájení. Nejde proto o prostou výměnu GPU na libovolné sériové desce RTX 3090.
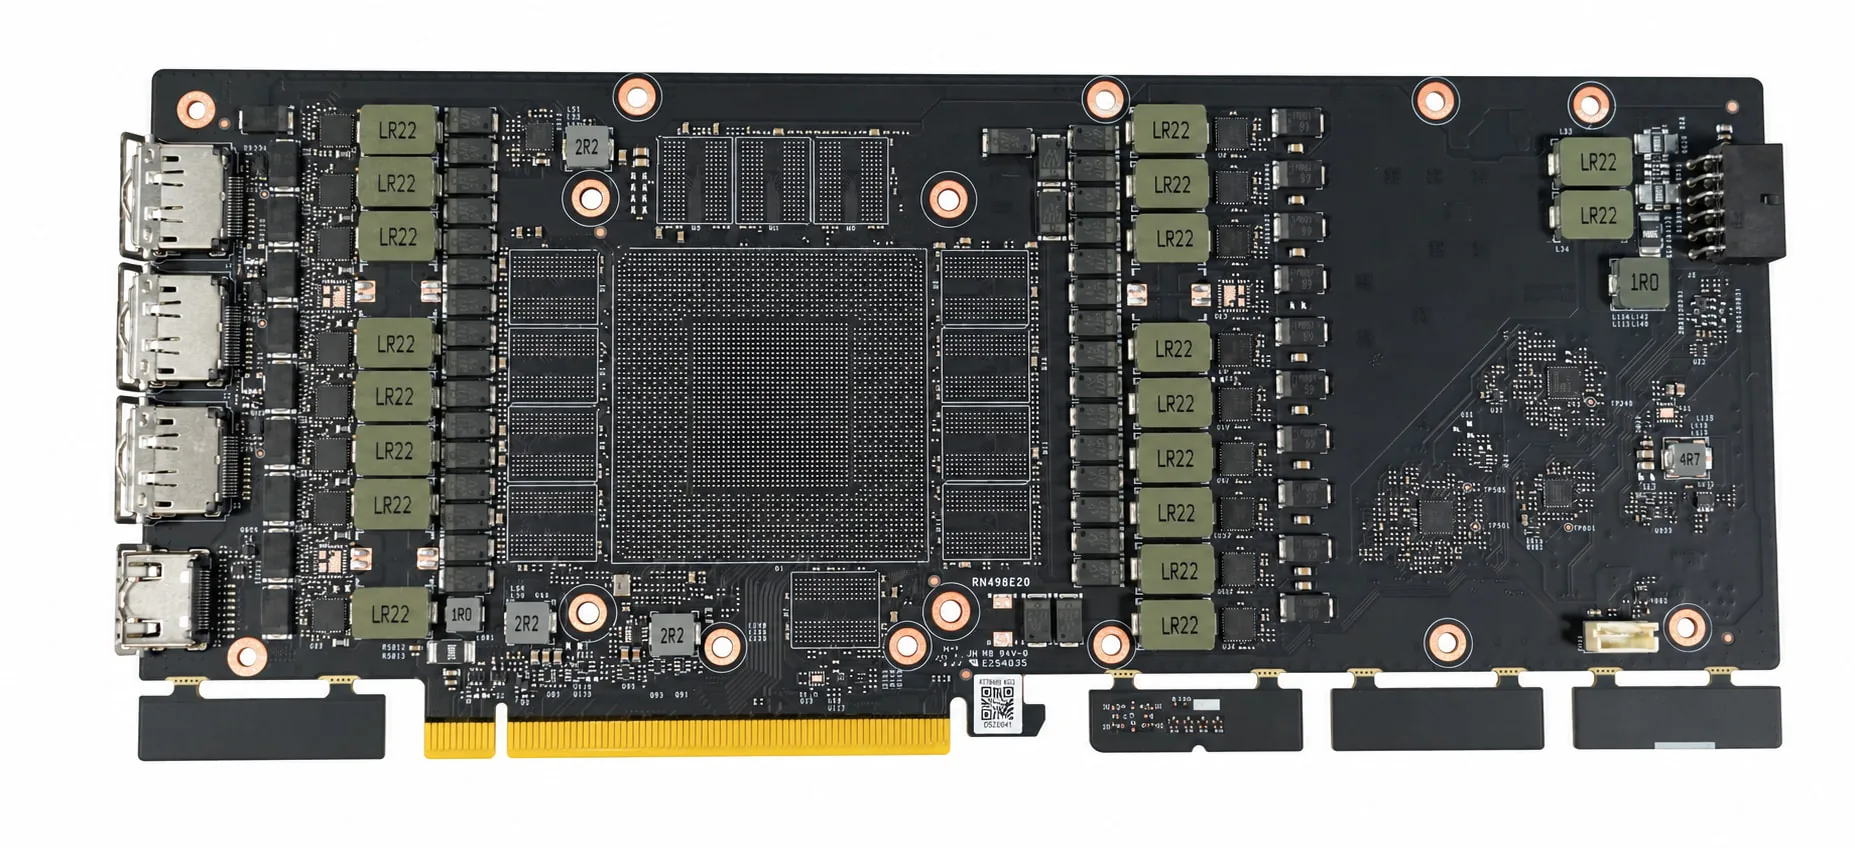
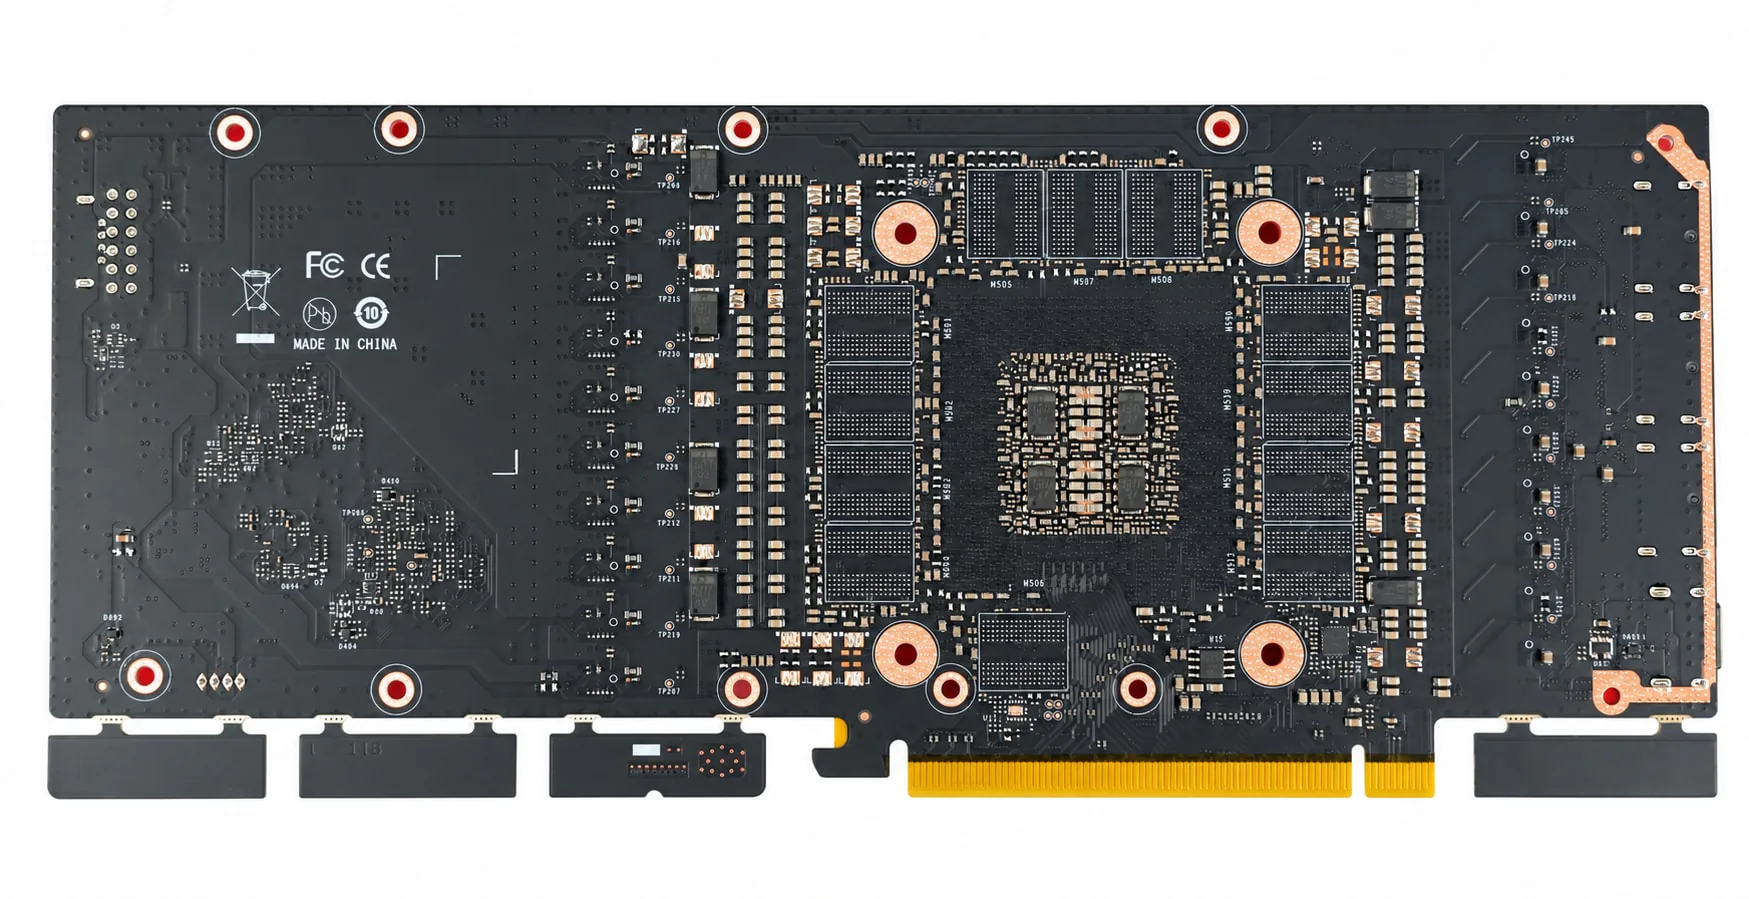
Z poškozené desky na nové PCB
Pod grafickým procesorem a 24 paměťovými čipy je dohromady přibližně 7 650 cínových pájecích kuliček, které při osazení vytvoří spoje s PCB grafické karty. Každý z těchto drobných spojů musí být kvalitně provedený — jediný vadný spoj může způsobit nestabilitu nebo úplnou nefunkčnost karty.
Přenos začíná na infračervené BGA pájecí stanici: s řízeným předehřevem a teplotním profilem se sejme GPU a následně použitelné paměti. Po odstranění zbytků pájky a tavidla se zkontrolují kontaktní plochy. Přenášené čipy pak dostanou nové pájecí kuličky — tento krok se nazývá reballing neboli překuličkování. Připraví se také dalších dvanáct kompatibilních 2GB pamětí.
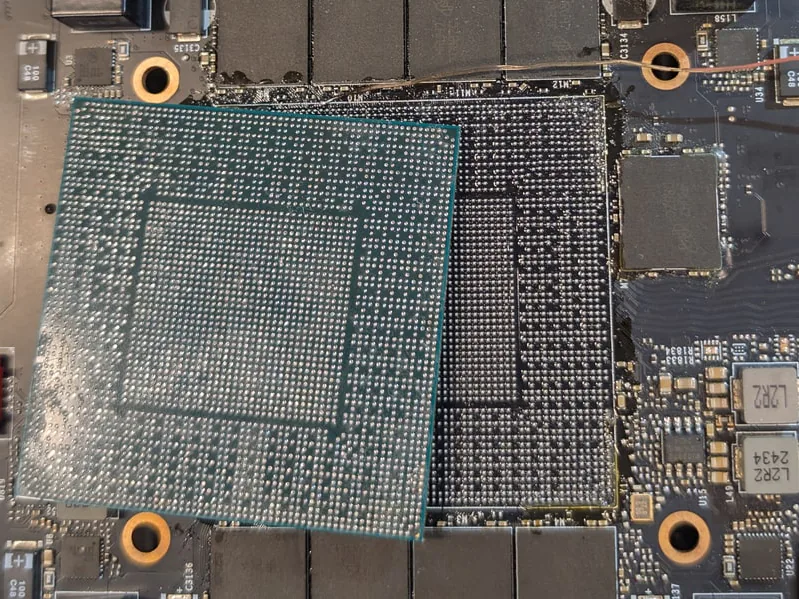
Grafický čip po odpájení z původní poškozené karty.
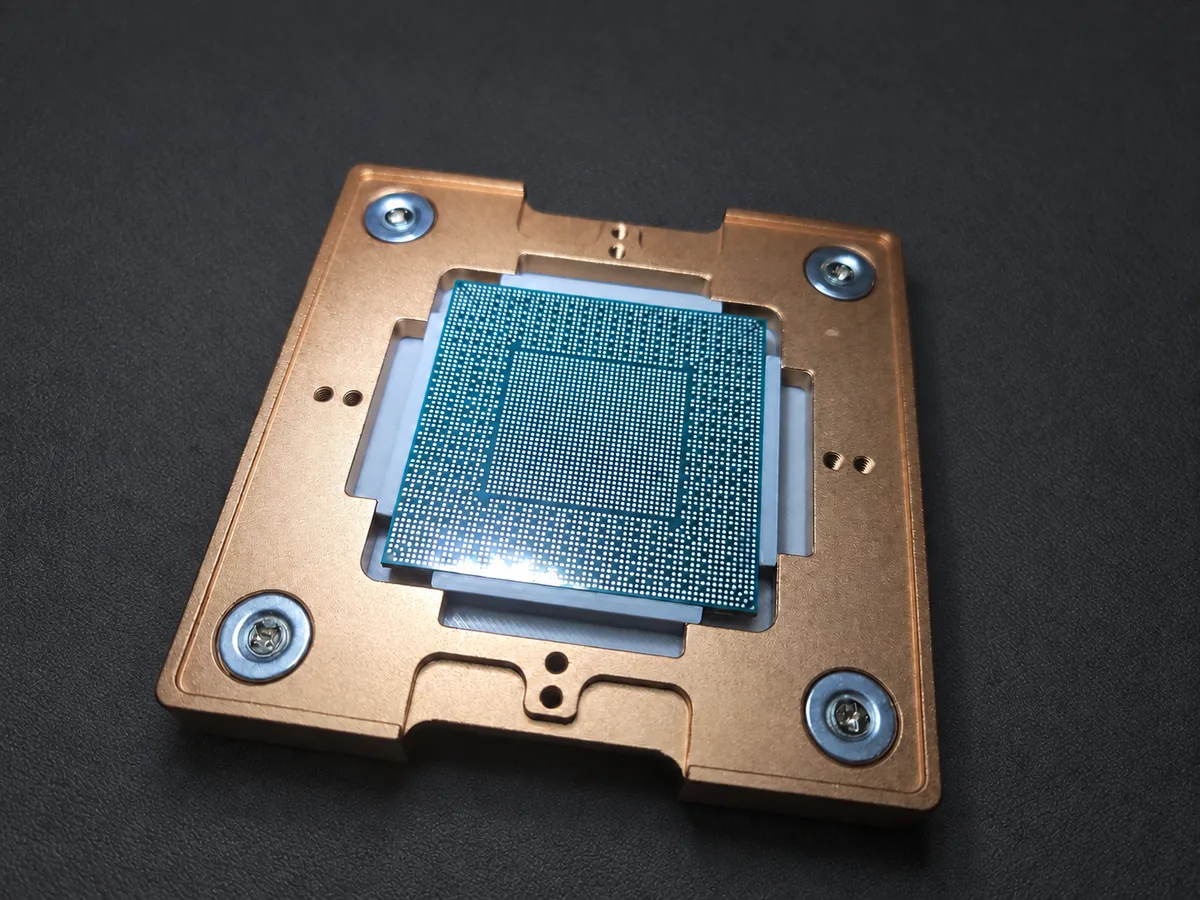
GPU po vyčištění od zbytků původní pájky v reballingovém přípravku.
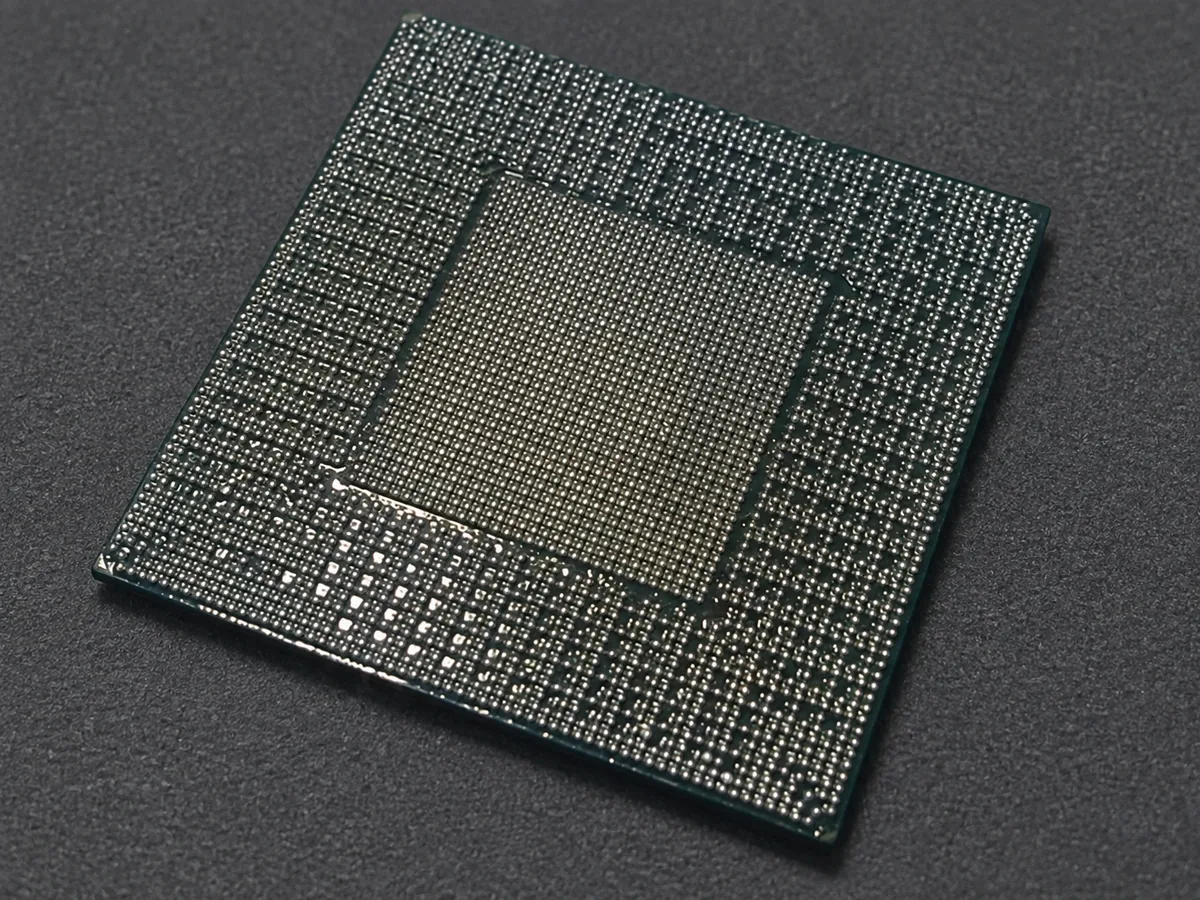
Grafický čip po reballingu — s novými pájecími kuličkami.
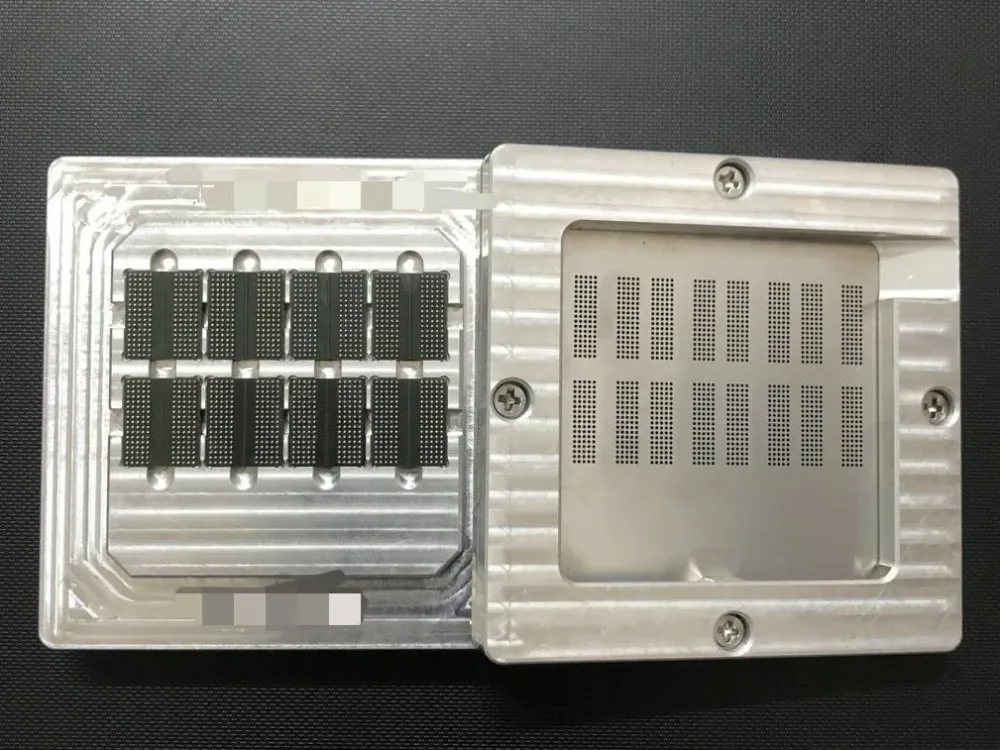
Paměťové čipy v přípravku pro reballing.
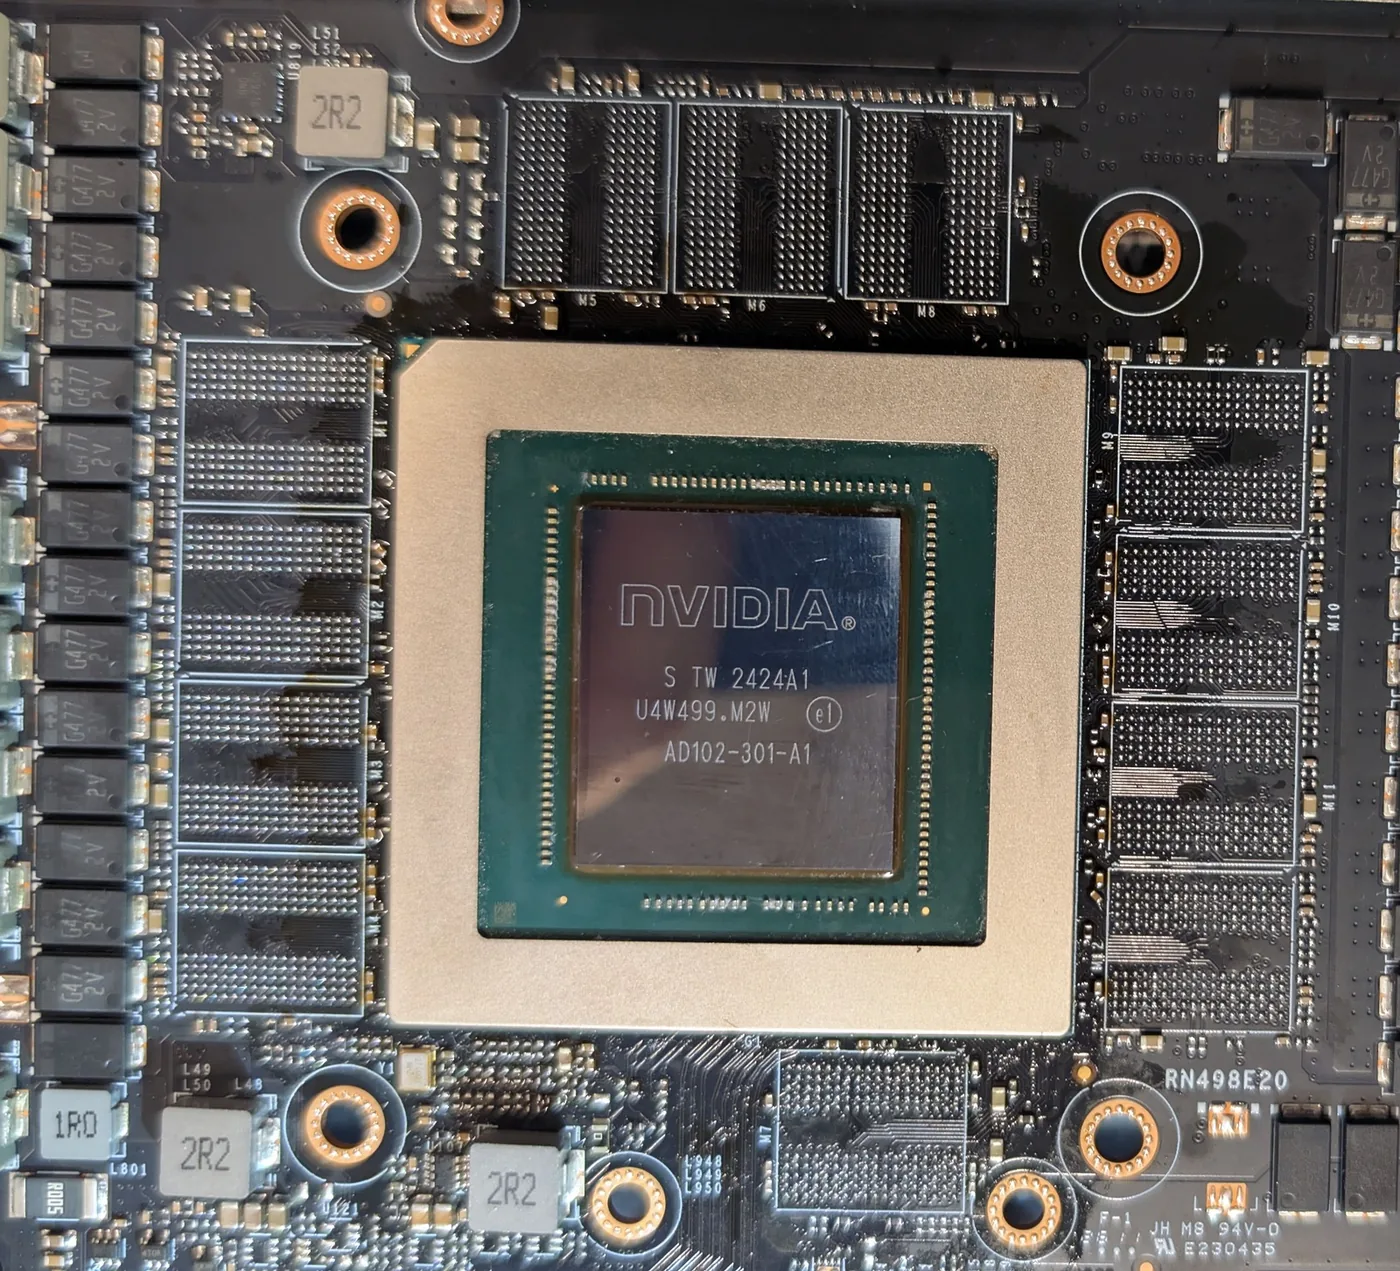
Grafický procesor AD102 na novém PCB, ještě před osazením paměťových čipů.
GPU i paměti se přesně vyrovnají a pomocí BGA stanice připájí na nové PCB. Paměti na obou stranách desky potřebují odpovídající chlazení. Následuje přizpůsobení firmwaru/VBIOSu konkrétnímu zapojení a kapacitě, kontrola osazení a napájení a teprve potom první spuštění, ověření detekované paměti a provozní zkoušky.
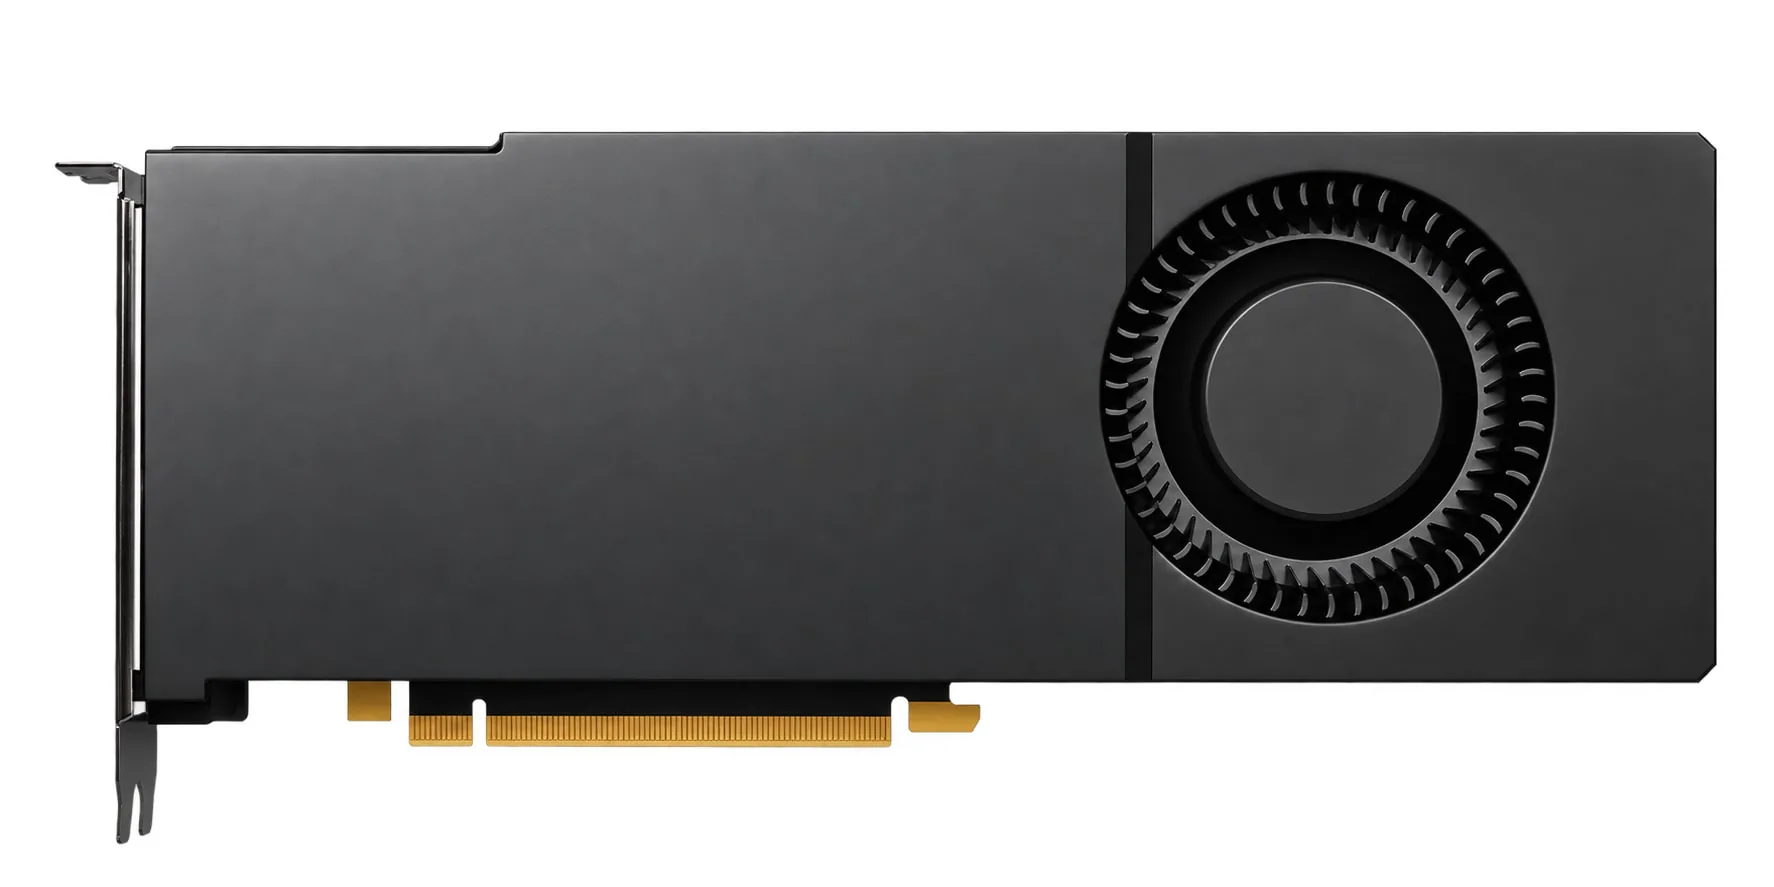
Z mechanicky poškozené karty se tak na nové PCB přenese grafický procesor a jeho původních dvanáct 2GB pamětí. Dalších dvanáct kompatibilních 2GB čipů doplní druhou stranu desky. Spolu s odpovídajícím nastavením VBIOSu tím vznikne RTX 4090 s 48 GB fyzicky osazené VRAM.
První kartu jsme takto zprovoznili. Následovalo to podstatné: ověřit, zda větší paměť skutečně využije aplikace a jak se sestava chová při lokální AI.
Proč 48 GB: konkrétní větší model
Model potřebuje místo nejen pro své váhy, ale také pro pracovní data a KV cache — průběžnou paměť předchozích tokenů. Delší kontext může nároky zvýšit. Rozhoduje skutečná spotřeba VRAM, nikoli jen velikost staženého souboru.
V dřívějším samostatném testu modelu Qwen3.6-35B-A3B Abliterated Q8_0 jsme naměřili 34,86 GiB obsazené VRAM. Taková konfigurace přesahuje nejen 24 GB běžné RTX 4090, ale i 32 GB GeForce RTX 5090 — současné vlajkové lodi herní řady NVIDIA. Na menší kartě by bylo potřeba změnit nastavení nebo přesunout část zátěže do systémové paměti; neznamená to, že model nelze spustit vůbec.
Deset minut s větším modelem: výsledky a průběh měření
Model Qwen3.6 Q8 zůstal po celý desetiminutový test načtený v grafické kartě. Postupně zpracoval 158 navazujících požadavků bez jediného opětovného načtení. Obsazení VRAM dosáhlo 34,86 GiB; medián rychlosti generování byl přibližně 139,5 tokenu za sekundu.
Graf ukazuje skutečný průběh teploty jádra a příkonu. GPU se dostalo nejvýše na 63 °C, průměrný příkon v měřeném intervalu byl přibližně 247 W. V záznamu nebyly nové chyby GPU ani nedostatku paměti.
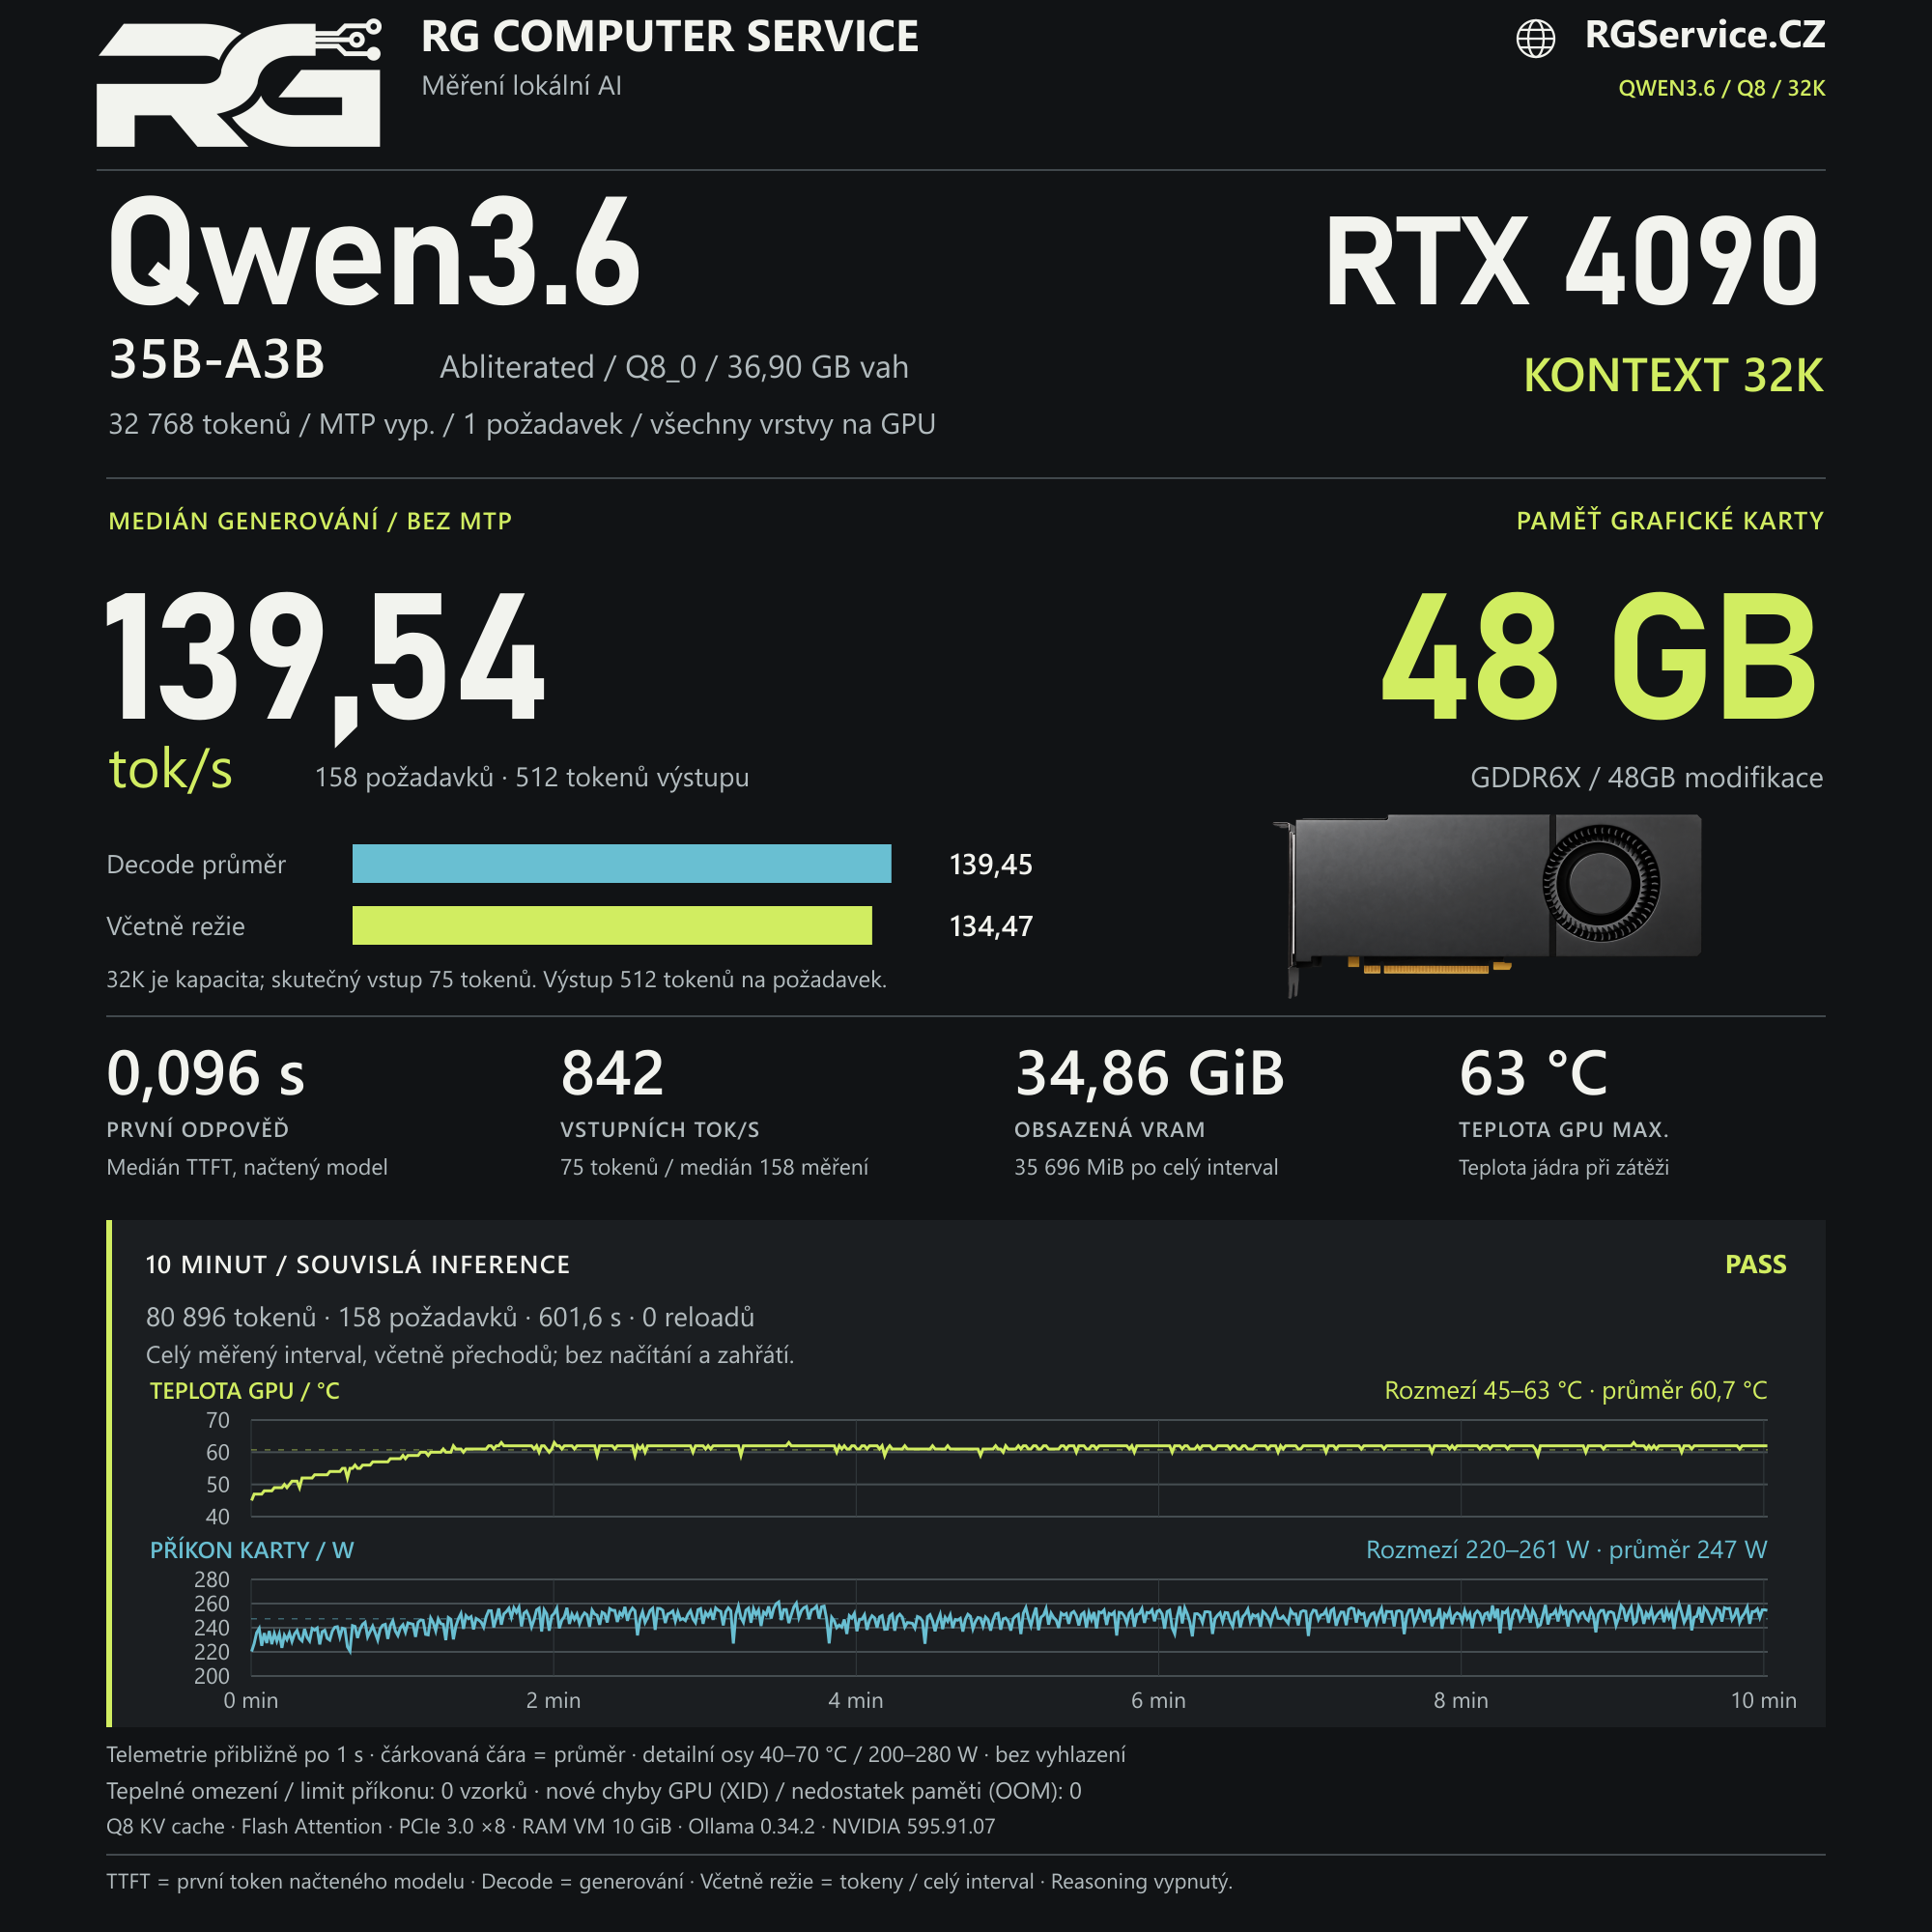
Jak tento test číst: šlo o sérii krátkých vstupů, na které model generoval vždy 512 tokenů. Nastavené okno 32K vyjadřuje kapacitu kontextu; jednotlivé vstupy měly 75 tokenů. Uvažování i MTP byly vypnuté. První načtení a zahřátí proběhly před zobrazeným intervalem. Takto jsme sledovali souvislý provoz a využití paměti; řešení konkrétních servisních úloh následuje v dalším srovnání.
Větší paměť nám otevřela prostor pro náročnější modely. Teď nás zajímala další praktická otázka: kolik času při stejném zadání ušetří vyladěný jazykový model?
Původní Qwen versus ThinkingCap od BottleCap AI
Do testování nám přišla vhod novinka od českého startupu BottleCap AI. Pražský tým se věnuje efektivitě jazykových modelů a vydal ThinkingCap — vyladěnou verzi Qwenu, která má omezit zbytečně dlouhé přemýšlení. Českou práci v téhle oblasti jsme si chtěli vyzkoušet na vlastní sestavě. Postavili jsme proto ThinkingCap proti původnímu Qwenu a oběma zadali stejné servisní úlohy.
Na jedné straně stojí původní Qwen3.8-27B, na druhé oficiální ThinkingCap-Qwen3.8-27B od BottleCap AI. Mají stejný modelový základ; v tomto srovnání není komunitní Heretic. Oba používají Q8_0, Q8 KV cache a zapnuté uvažování xhigh. MTP je vypnuté, takže tu neporovnáváme účinek spekulativního generování.
BottleCap AI ve své vlastní metodice uvádí průměrně o 37,2 % méně tokenů uvažování přes dvanáct benchmarků, při změně průměrné přesnosti z 86,65 % na 85,79 %. Jde o výsledky autorů v jiném prostředí, nikoli o čísla naměřená v našem servisu. Metodika a výsledky BottleCap AI
Místo dlouhého seznamu hádanek jsme zvolili tři konkrétní úlohy inspirované servisní praxí:
- Nákup dílů: vybrat nejlevnějšího způsobilého dodavatele, správně započítat množstevní slevu a dopravu a určit zbytek rozpočtu.
- Plánování opravy: sestavit nejrychlejší proveditelný harmonogram, ve kterém část úkonů vyžaduje technika a část běží automaticky. Nestačí pouze sečíst délky všech kroků.
- Rozhodnutí podle dokumentace: v servisním exportu s 95 datovými řádky najít platnou revizi postupu, odlišit ji od starších verzí a rozhodnout, zda dvě opravy splňují podmínky pro vydání. Odpověď musí uvést také rozhodující zdroje.
Podklady jsme vytvořili pro test; neobsahují zákaznická data. Před hlavním měřením jsme na jiných konkrétních zadáních ověřili, které typy úloh oba modely zvládnou dokončit v časovém a tokenovém limitu. Z tohoto pilotu vzešly tři testované kategorie.
Každé finální zadání dostal každý model dvakrát, s párovanými seedy 42 a 43. Základní srovnání tak obsahuje 12 odpovědí, šest na model. Konkrétní zadání i referenční výsledky jsme uzavřeli před zahájením finálních běhů. Zadání jsou anglicky; nejde tedy zároveň o test kvality češtiny.
Nákup dílů
- Qwen
- 15,8 s
- ThinkingCap
- 9,0 s
Medián dvou běhů. Oba modely: 2/2 správně.
Plánování opravy
- Qwen
- 15,6 s
- ThinkingCap
- 11,6 s
Medián dvou běhů. Oba modely: 2/2 správně.
Servisní dokumentace
- Qwen
- 34,3 s
- ThinkingCap
- 18,9 s
Medián dvou běhů. Oba modely: 2/2 správně.
Oba modely správně dokončily všech šest hlavních odpovědí. Načítání modelu není součástí těchto časů. Každý sloupec ukazuje medián dvou pokusů; malá úsečka jejich rozmezí.
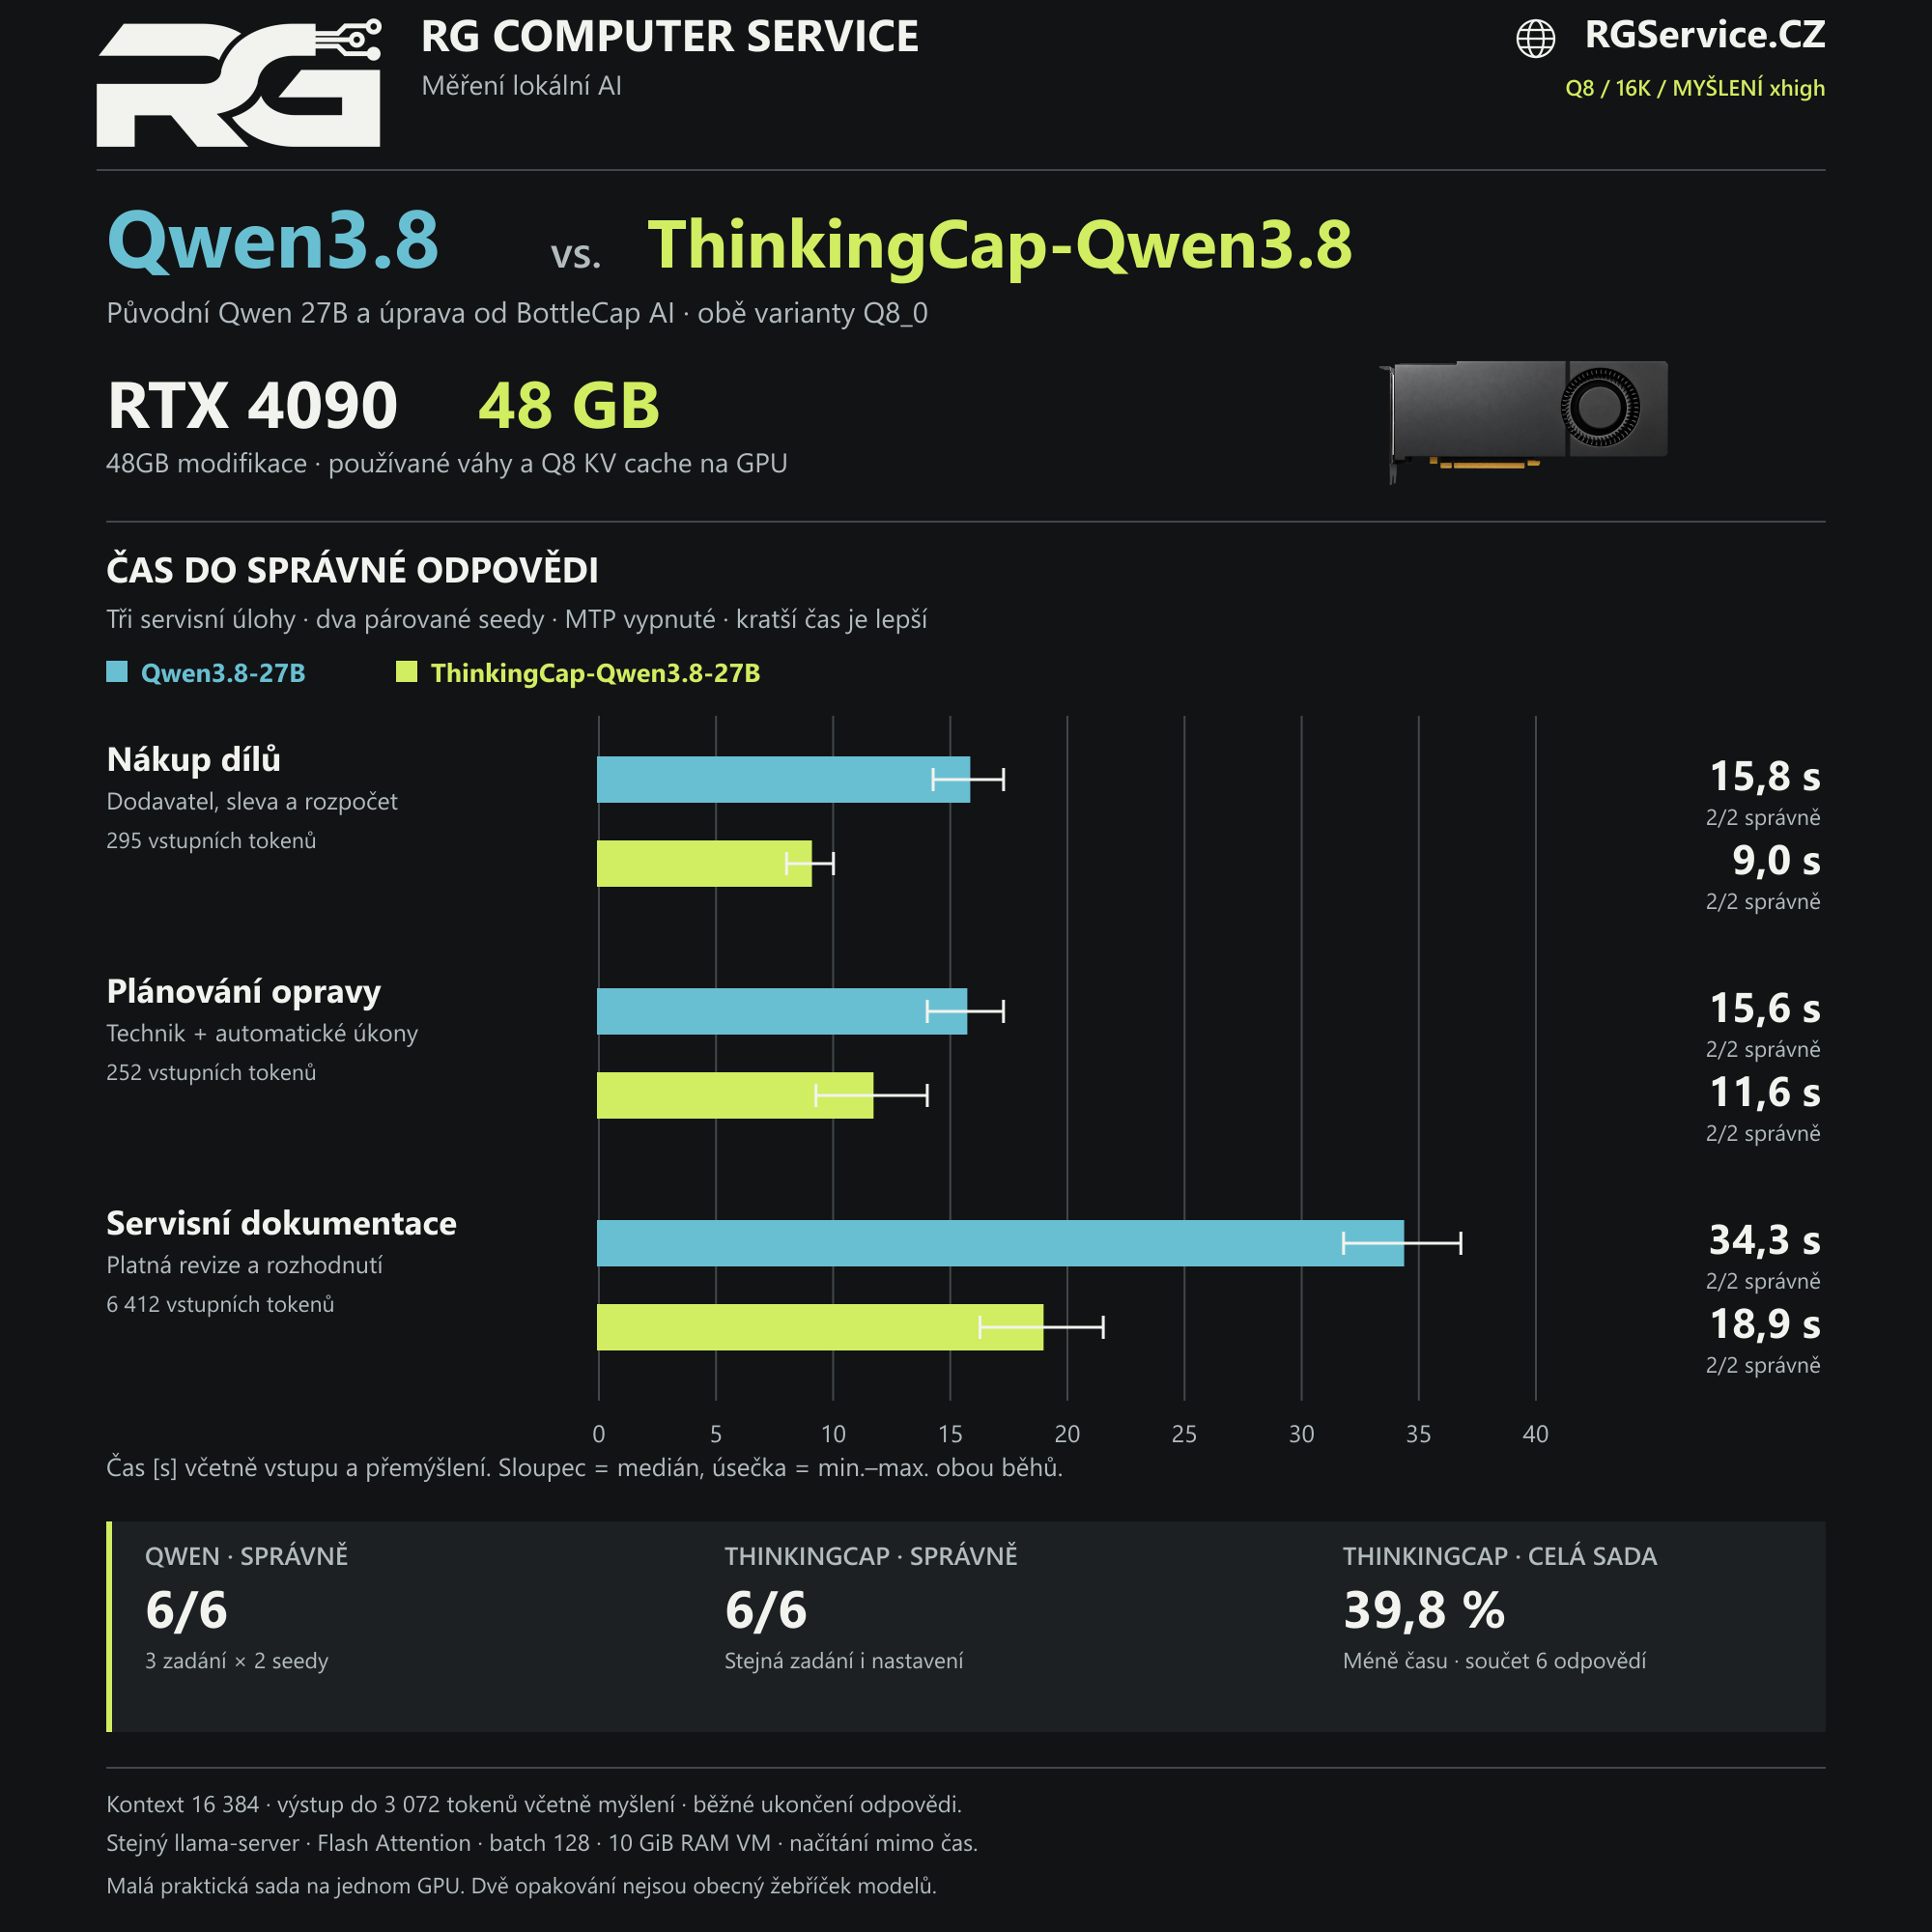
Přesné hodnoty a rozmezí obou pokusů
| Úloha | Qwen: medián (rozsah) | ThinkingCap: medián (rozsah) | Správně Qwen · TC |
|---|---|---|---|
| Nákup dílů | 15,8 s (14,3–17,3) | 9,0 s (8,0–10,0) | 2/2 · 2/2 |
| Plánování opravy | 15,6 s (14,0–17,3) | 11,6 s (9,3–14,0) | 2/2 · 2/2 |
| Servisní dokumentace | 34,3 s (31,8–36,8) | 18,9 s (16,3–21,5) | 2/2 · 2/2 |
Součet časů šesti správných odpovědí byl u původního Qwenu 131,4 s a u ThinkingCapu 79,1 s. V této konkrétní sadě tedy ThinkingCap potřeboval 39,8 % méně času. Nejde o průměrnou úsporu na libovolné úloze.
Zajímavé je, odkud rozdíl přišel. Bez MTP oba modely generovaly přibližně 30 tokenů za sekundu. Původní Qwen ale pro šest odpovědí vytvořil celkem 3 735 výstupních tokenů, ThinkingCap 2 137. V tomto měření tedy kratšímu čekání odpovídalo hlavně méně generovaného textu včetně uvažování, nikoli vyšší rychlost jednotlivých tokenů.
V obou časových údajích je zpracování vstupu, přemýšlení i dokončení finální odpovědi. Počty výstupních tokenů a všechny jednotlivé běhy jsou v rozbalitelné metodice.
Čas měříme až do úplné správné odpovědi, včetně zpracování vstupu a uvažování. Samotné tokeny za sekundu neříkají, jak dlouho bude uživatel čekat.
Co přidá MTP: rychlejší generování není celý příběh
MTP využívá návrhy několika dalších tokenů, které model následně ověřuje. Přijaté návrhy mohou generování urychlit; záleží ale na konkrétním modelu, vstupu a běhovém prostředí. Neznamená to automaticky stejné zrychlení celého požadavku.
Na stejné dokumentové úloze jsme proto u obou modelů přidali nativní MTP s délkou návrhu čtyři tokeny. Ostatní nastavení, vstup a párované seedy zůstaly stejné. Čtyři odpovědi s MTP doplňují čtyři již změřené dokumentové odpovědi bez MTP; celá nová sada tak má 16 odpovědí.
Přínos MTP zde ověřujeme na jedné vybrané úloze, nikoli napříč všemi druhy zadání.
Qwen · dokumentace
- Bez MTP
- 34,3 s
- MTP 4
- 13,4 s
Generování: 30,2 → 69,9 tok/s. Mediány dvou běhů; všechny správně.
ThinkingCap · dokumentace
- Bez MTP
- 18,9 s
- MTP 4
- 10,6 s
Generování: 30,2 → 77,3 tok/s. Mediány dvou běhů; všechny správně.
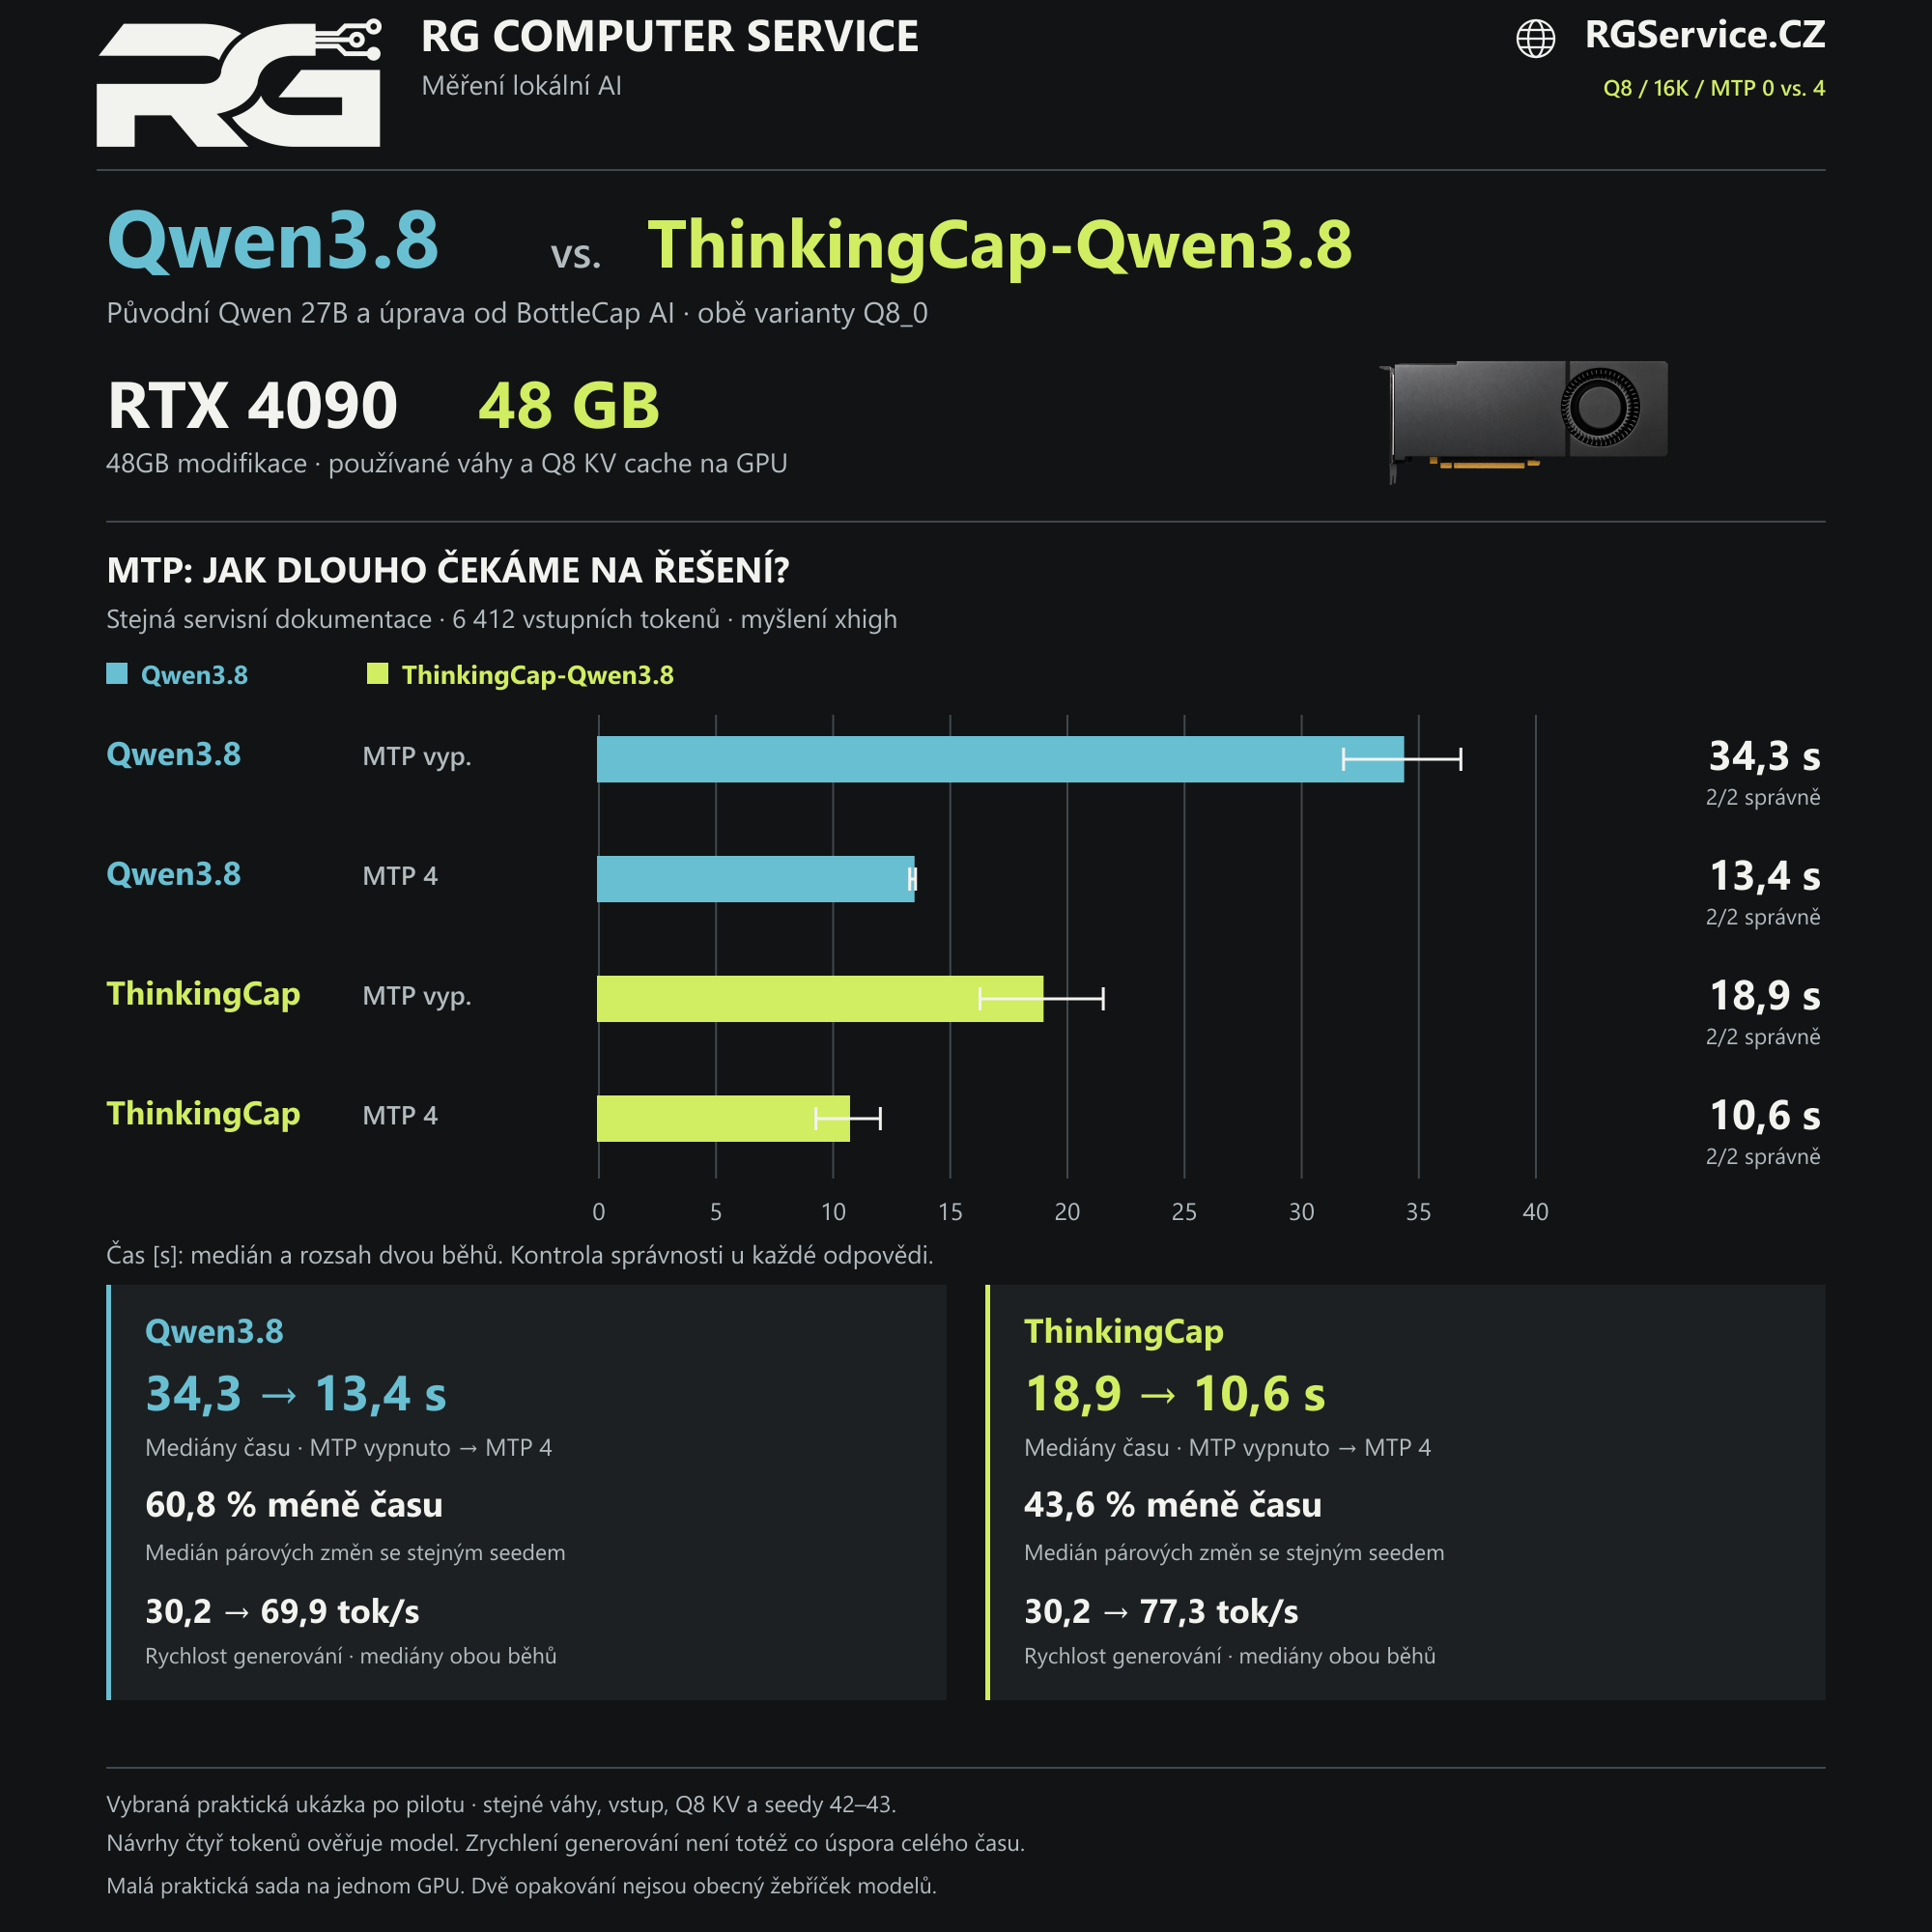
Přesné hodnoty a rozmezí obou pokusů
| Model | MTP | Celý požadavek: medián (rozsah) | Generování: medián (rozsah) | Správně |
|---|---|---|---|---|
| Qwen3.8 | vypnuto | 34,3 s (31,8–36,8) | 30,2 tok/s (30,2–30,2) | 2/2 |
| Qwen3.8 | MTP 4 | 13,4 s (13,3–13,5) | 69,9 tok/s (65,8–74,0) | 2/2 |
| ThinkingCap | vypnuto | 18,9 s (16,3–21,5) | 30,2 tok/s (30,2–30,2) | 2/2 |
| ThinkingCap | MTP 4 | 10,6 s (9,3–12,0) | 77,3 tok/s (76,8–77,8) | 2/2 |
Generování a čas celé úlohy jsou různé metriky. MTP může změnit i délku konkrétní vygenerované odpovědi; kontrolujeme proto správnost každého výsledku. Výše zůstávají oba pokusy v každé konfiguraci, nikoli jen ten rychlejší.
Jak měříme a co výsledky neznamenají
Toto je malá praktická sada na jednom konkrétním kusu hardwaru. Není to všeobecné pořadí schopností modelů ani opakování rozsáhlé studie jejich autorů. Zadání, referenční řešení a pravidla hodnocení jsou uzavřené před hodnocenými běhy; nevybíráme až následně jen příklady, které zvýhodní jeden model.
Rozbalit metodiku, prostředí a výsledky jednotlivých zadání
K znamená 1 024 tokenů. Všechny nové úlohy mají kapacitu okna 16 384 tokenů; to neznamená, že mají stejně dlouhý vstup. Dokument obsahuje přibližně 6,4 tisíce vstupních tokenů. Počítáme celý vstup včetně instrukcí a chat template. Každá odpověď má společný limit 3 072 výstupních tokenů včetně uvažování a 150 sekund. Načtení modelu není součástí času odpovědi.
Sampling: teplota 1, top_p 0,95, top_k 20, min_p 0, presence penalty 0 a repetition penalty 1. Seedy 42 a 43 jsou párované. Flash Attention je zapnutá, batch i microbatch jsou 128. Současně běží jediný požadavek a je načtený jediný model. Váhy Q8_0 pocházejí od různých vydavatelů GGUF; neprohlašujeme jejich převodní postup za identický.
Model se načítá před měřením a načítání se eviduje odděleně. Každý dotaz zpracovává celý vstup bez znovupoužití předchozí prompt cache; kontroluje se to ve výstupu backendu i logu. Nepřidáváme nezapočítaná zahřívací zadání. Pořadí modelů se mezi seedy obrací a každý dotaz startuje po ochlazení GPU na nejvýše 45 °C. Ochlazování je mimo čas odpovědi. Tepelné ochrany ani power limit se kvůli výsledkům nezvyšují.
Čas do dokončení zahrnuje zpracování vstupu i generování, nikoli načtení modelu. Čas prvního generovaného tokenu může znamenat začátek uvažování, ne ještě finální odpovědi. Výstupní rychlost je uvedena samostatně podle časování backendu. Všech 16 hodnocených odpovědí je uložených v datové příloze.
Prostředí a všechny nové odpovědi
RTX 4090: 49 140 MiB VRAM, ovladač 595.91.07, nezměněný power limit 450 W. VM má 10 GiB RAM. Stejný instalovaný llama-server, sestavení 391fac164; používané váhy i Q8 KV cache jsou na GPU. Kontrolní součty vah a backendu jsou v příloze.
Maximum celé nové sady: 68 °C, 436,3 W a 28,98 GiB VRAM. Nové chyby Xid/OOM: 0/0; vzorky s tepelným omezením: 0. Telemetrie obsahuje 872 vzorků. Mezi úlohami se karta záměrně ochlazuje; není to souvislý desetiminutový zátěžový test.
| Úloha | Model | MTP | Seed | Výsledek | Čas [s] | Výstup [tok.] | Generování [tok/s] |
|---|---|---|---|---|---|---|---|
| F3: Servisní dokumentace | Qwen3.8 | 0 | 42 | správně | 31,79 | 853 | 30,19 |
| F1: Nákup dílů | Qwen3.8 | 0 | 42 | správně | 17,27 | 513 | 30,57 |
| F2: Plánování opravy | Qwen3.8 | 0 | 42 | správně | 14,02 | 416 | 30,53 |
| F3: Servisní dokumentace | ThinkingCap | 0 | 42 | správně | 16,27 | 384 | 30,19 |
| F1: Nákup dílů | ThinkingCap | 0 | 42 | správně | 10,01 | 295 | 30,68 |
| F2: Plánování opravy | ThinkingCap | 0 | 42 | správně | 9,26 | 268 | 30,39 |
| F3: Servisní dokumentace | ThinkingCap | 0 | 43 | správně | 21,53 | 542 | 30,15 |
| F1: Nákup dílů | ThinkingCap | 0 | 43 | správně | 8,01 | 230 | 30,57 |
| F2: Plánování opravy | ThinkingCap | 0 | 43 | správně | 14,02 | 418 | 30,63 |
| F3: Servisní dokumentace | Qwen3.8 | 0 | 43 | správně | 36,80 | 1008 | 30,25 |
| F1: Nákup dílů | Qwen3.8 | 0 | 43 | správně | 14,27 | 427 | 30,67 |
| F2: Plánování opravy | Qwen3.8 | 0 | 43 | správně | 17,27 | 518 | 30,65 |
| F3: Servisní dokumentace | Qwen3.8 | 4 | 42 | správně | 13,27 | 700 | 74,01 |
| F3: Servisní dokumentace | ThinkingCap | 4 | 42 | správně | 9,26 | 409 | 76,83 |
| F3: Servisní dokumentace | ThinkingCap | 4 | 43 | správně | 12,01 | 641 | 77,77 |
| F3: Servisní dokumentace | Qwen3.8 | 4 | 43 | správně | 13,52 | 631 | 65,85 |
Zadání, odpovědi, nastavení, kontrolní součty a data ke stažení
Původní doplňková měření: MTP a provozní zátěž
Následující graf vznikl dříve a za jiných podmínek: kontext 8K, devět krátkých běhů pro každou konfiguraci, uvažování vypnuté. Porovnává MTP vypnuté a délku návrhu čtyři tokeny. Mediány původního Qwenu byly 30,02 a 55,98 tok/s, ThinkingCapu 30,10 a 51,45 tok/s. Tyto hodnoty se neslučují s novou sadou uvažování.
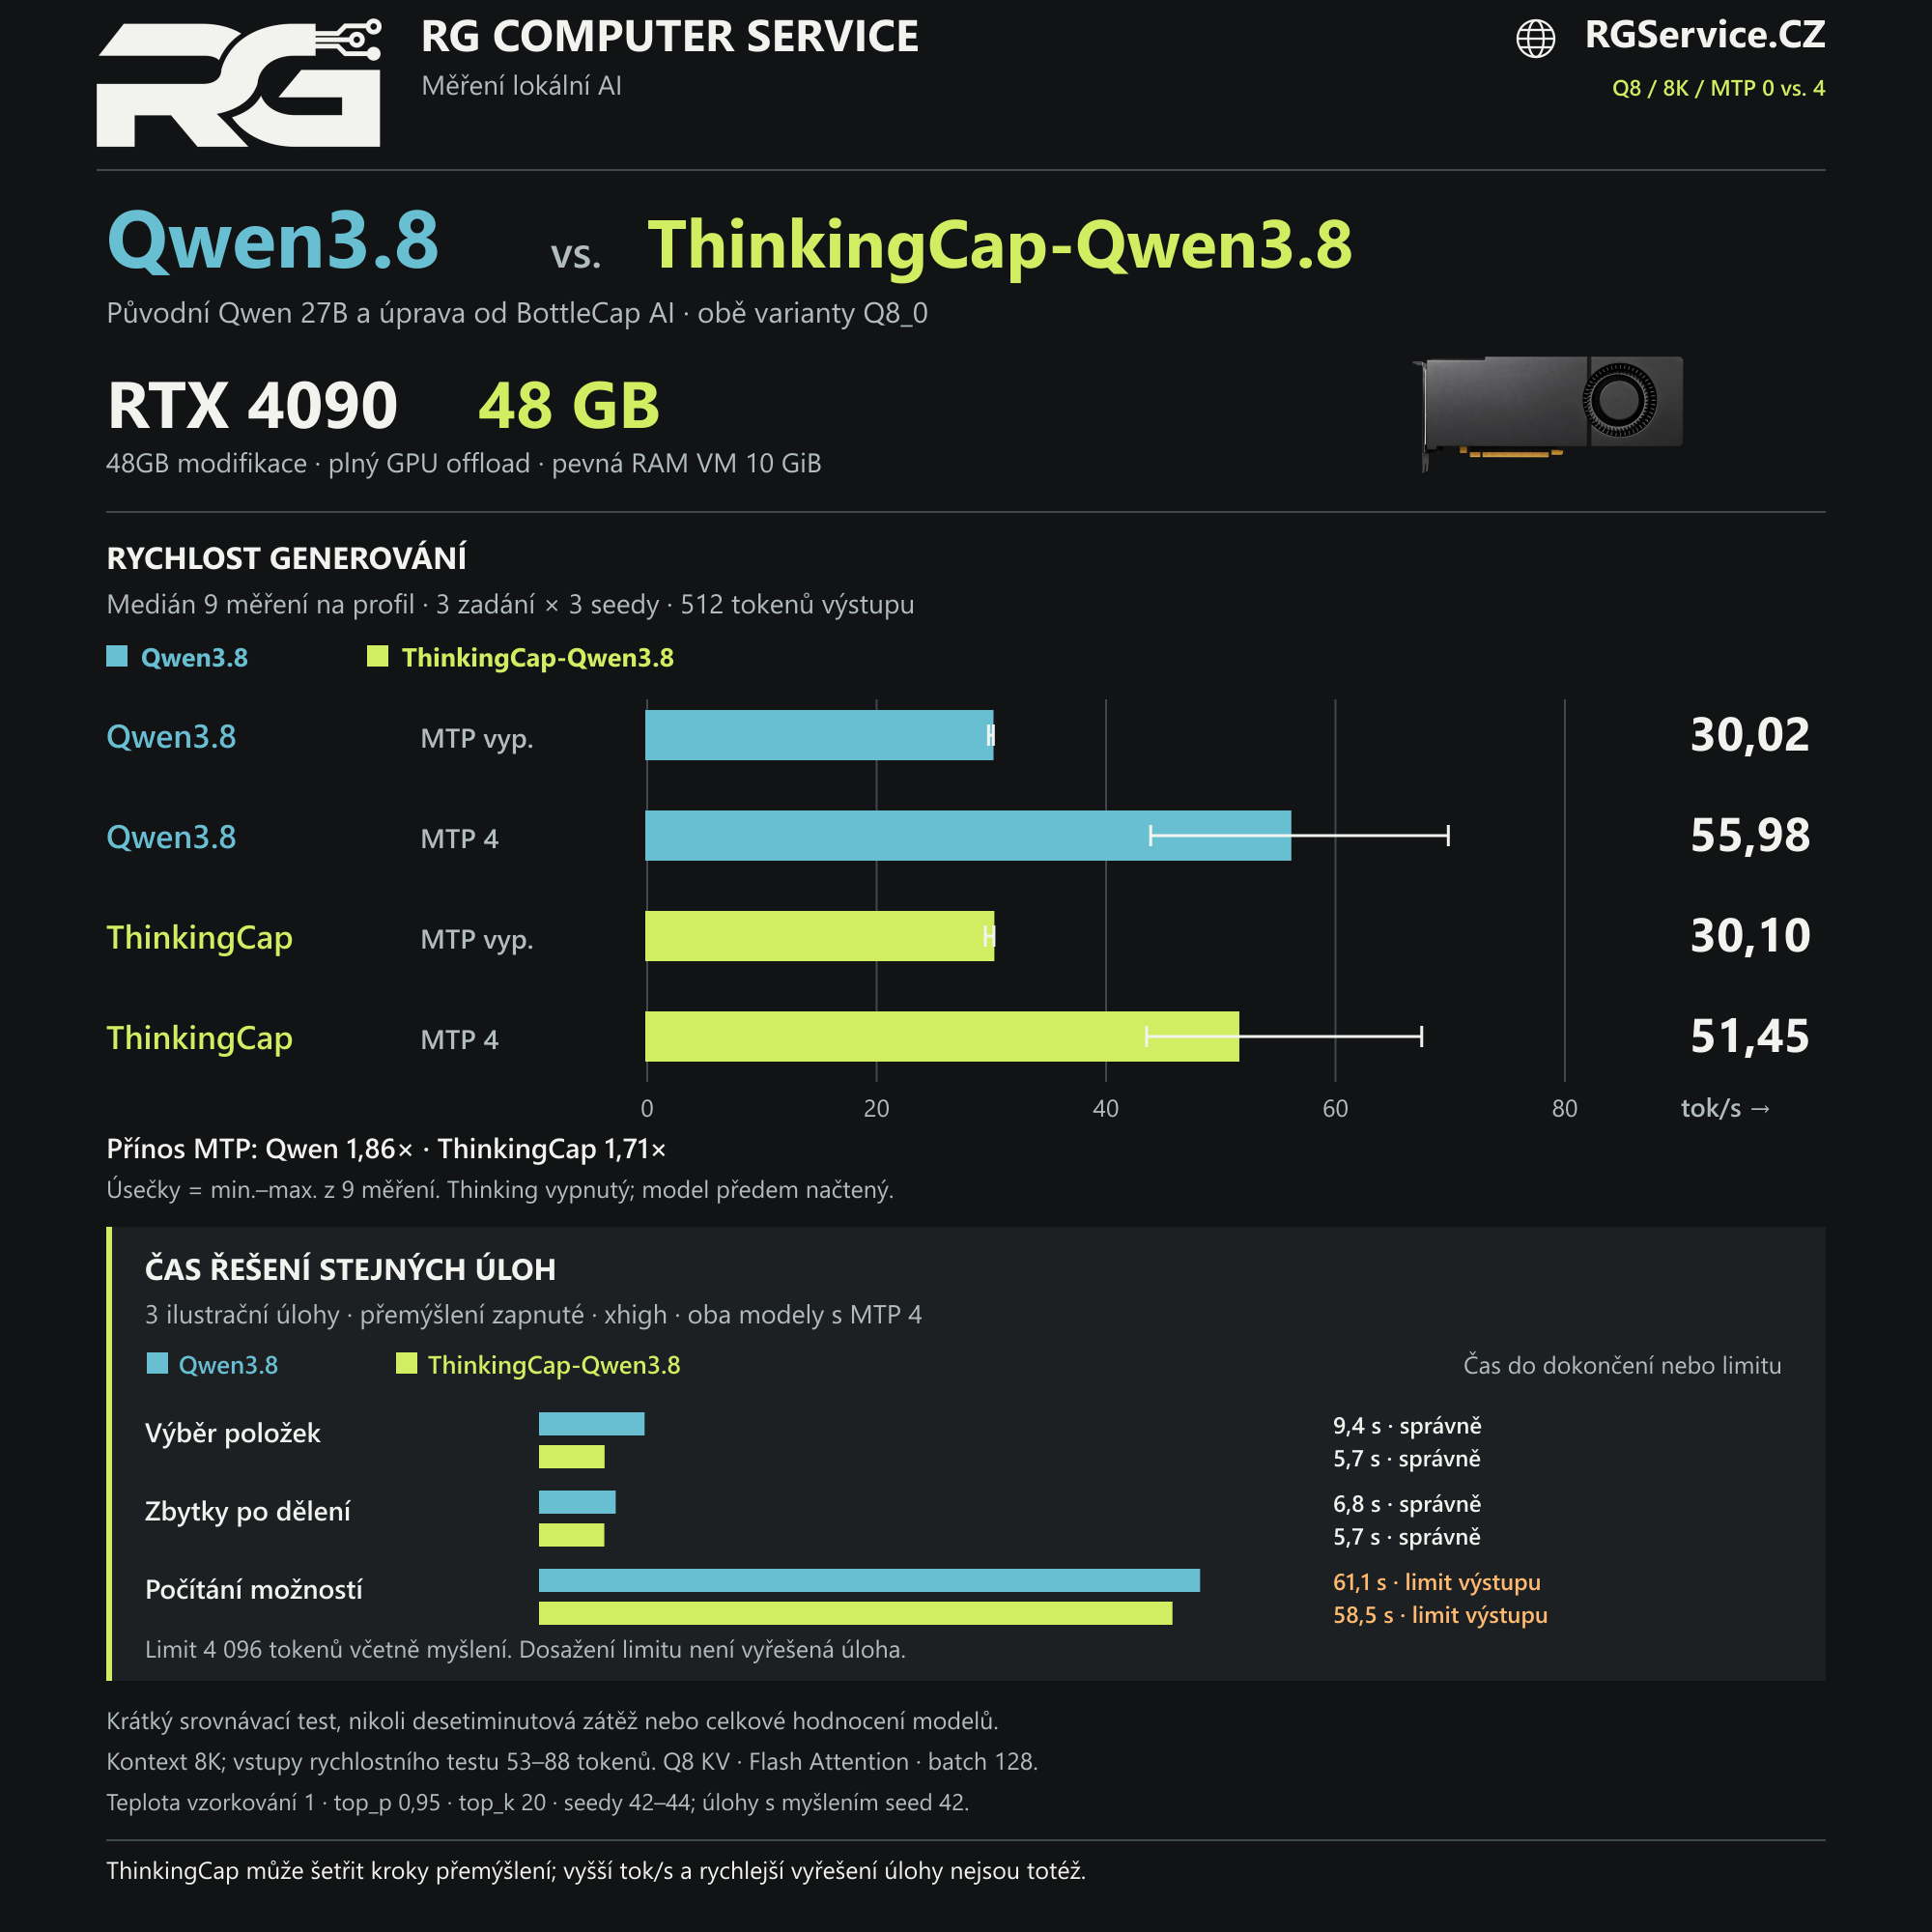
Z opravy vznikl použitelný nástroj
Nejdůležitějším výsledkem přestavby je zprovoznění prvního konkrétního kusu: GPU, které mohlo skončit spolu s poškozenou deskou, pracuje v sestavě pro lokální AI s větší pamětí. Měření přidává ověřitelné údaje o konkrétních úlohách, nikoli univerzální slib pro každý model a každé použití.
Na třech vybraných úlohách přinesl ThinkingCap kratší čekání při správném výsledku. MTP pak zkrátilo dokumentovou úlohu u obou modelů. Jsou to dva různé přínosy: méně generovaných tokenů a rychlejší generování. Ani jeden nenahrazuje kontrolu správnosti odpovědi.
Pro nás v RG Computer Service je na tom zajímavé propojení práce na hardwaru s ověřením výsledku v reálné aplikaci. Samotná oprava je začátek; teprve provoz ukáže, co nová konfigurace uživateli skutečně přinese.
Příště: AI, která na všechno řekne „ANO“?
Kartu máme postavenou, výkon změřený. Příště se podíváme na samotné odpovědi. Stejné otázky položíme ThinkingCapu od BottleCap AI, jeho komunitně upravené variantě Heretic a ChatGPT.
Čím je Heretic zajímavý? Jde o neoficiální komunitní úpravu ThinkingCapu, jejímž cílem je, aby model častěji řekl „ano, pomůžu“ místo „s tímhle vám nemůžu pomoci“. Jak daleko tahle ochota sahá? A znamená méně odmítání také lepší odpovědi?
Připravili jsme deset otázek, na kterých rozdíly ukážeme vedle sebe. Dalších pět vybereme z vašich návrhů. Na co byste se zeptali vy? Napište nám do komentářů.


